SASRec:基于自注意力的序列推荐
总阅读量 加载中... 次
SASRec(Self-Attentive Sequential Recommendation)由 Wang-Cheng Kang 和 Julian McAuley 于 2018 年提出,发表于 ICDM 2018,论文题为 Self-Attentive Sequential Recommendation [1]。
SASRec 的核心思想是通过 带因果掩码的自注意力机制,从用户历史行为中提取与下一次交互相关的信息。模型使用可学习的位置向量表示行为顺序,通过逐位置前馈网络和堆叠的注意力模块形成序列表示,最后与候选物品向量计算内积,完成下一物品预测。
1. 背景
在 矩阵分解 中,用户通常由一个固定向量表示。它适合学习相对稳定的偏好,却没有直接描述行为先后顺序。例如,一个用户依次浏览了电脑、鼠标和打印机,下一次可能对打印纸感兴趣;把这段历史视为无序集合,会丢掉有用的上下文。
序列推荐希望根据按时间排序的交互记录,预测用户下一次交互的物品。马尔可夫链方法通常关注最近一次或几次行为,结构简单,但可能遗漏较远的依赖;RNN 可以逐步积累历史信息,却需要沿时间轴依次计算。
SASRec 使用自注意力在历史位置之间建立联系:当前表示既可以关注最近的行为,也可以利用更早的行为。训练时不同位置可以并行计算,但每个位置只能访问自己及之前的输入,不能看到未来的真实答案。
它与 DIN 的区别也很重要:DIN 通常以候选物品为条件,对用户历史进行兴趣激活;SASRec 首先从历史序列生成表示,再用这个表示给不同候选物品打分。两者都使用注意力,但注意力的查询来源和预测方式不同。
2. 模型架构
2.1 整体网络结构
SASRec 的整体模型架构如下图所示。
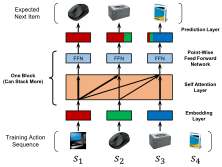
SASRec架构图
图中省略了位置向量、LayerNorm、Dropout 和残差连接等细节,下文将逐一说明。
图中底部的完整训练序列为
| 预测位置 | 允许访问的输入 | 正样本目标 |
|---|---|---|
| 1 |
|
|
| 2 |
|
|
| 3 |
|
|
模型由四个部分组成:
- Embedding Layer:将物品 ID 转为向量,并加入可学习的位置向量。
- Self-Attention Layer:在不访问未来信息的前提下,聚合历史行为。
- Point-Wise Feed-Forward Network:对每个位置应用相同的非线性变换。
- Prediction Layer:用序列表示与候选物品向量的内积计算相关性分数。
一个 Self-Attention Block 包含注意力子层和前馈子层,可以堆叠多层。原始模型不要求显式的用户 ID Embedding,用户表示由其历史行为产生。
2.2 输入层
设某用户的训练交互序列为:
先构造输入
例如,
input = [0, 0, 4, 7, 2]
pos = [0, 0, 7, 2, 9]
mask = [0, 0, 1, 1, 1]
补零位置不提供监督信号。注意,目标中的最后一个物品可以位于输入窗口之外,所以应该先构造错位输入和目标,再截断,而不是先截取
设物品 Embedding 矩阵为
整体输入为
实现时,即使物品 0 的向量固定为零,加上位置向量后也可能非零,因此还需要显式屏蔽 Padding。输入层可以使用 Dropout 缓解过拟合。
2.3 自注意力层
(1)缩放点积注意力
以单头注意力为例,输入为
其中
Softmax 沿 Key 维度计算。位置
(2)因果掩码与补零掩码
忽略 Padding 时,四个位置的可见关系为:
这里 1 表示允许访问。位置
补零还需要区分 Key 掩码和 Query 掩码:前者不让有效位置读取虚假的历史物品,后者将无效位置的输出清零。对于左侧补零行,所有 Key 都可能不可见;直接对一整行
(3)单头与多头
SASRec 可以使用单头或多头注意力。单头已经能形成 SASRec 的完整模型,并不要求采用多头。扩展到
2.4 前馈网络与模块堆叠
注意力负责在不同历史位置之间传递信息,前馈网络负责对每个位置的表示进行非线性变换:
SASRec 的两层前馈权重均为
残差与归一化形式为:
其中
LayerNorm 在每个位置的特征维度上计算,不在序列长度维度上统计;残差连接帮助保留已有表示。每层之后仍要将 Padding 位置清零。
对于
参数量约为
2.5 预测层
设最终位置表示为
输入物品与输出候选物品共享 Embedding 矩阵
训练时,每个有效位置都预测下一物品;推理时,将截至当前的历史作为输入,取最后一个有效位置的表示。对于左侧补零且非空的序列,它就是最后一列
对候选集合
打分排序不需要先做 Sigmoid。候选集不能包含 Padding ID;是否过滤已经交互过的物品,应由具体业务和评估协议决定。对完全没有历史的用户,需要另外设计冷启动策略。
2.6 损失函数
原始 SASRec 使用带负采样的二元交叉熵,而不是 BPR 成对排序损失,也不是对全物品集合做 Softmax。
令
负例应来自当前用户训练历史中未交互的物品,排除 Padding 和该位置的正样本。负采样需要与训练数据划分配合,不能为了训练而读取未来验证、测试交互。
数值实现可以使用:
这与上式等价,但避免了先计算 Sigmoid 再取对数造成的数值问题。采样训练得到的分数用于物品相关性排序,不能直接当作经过校准的真实点击率。
3. 模型实现
3.1 核心代码实现
下面用 PyTorch 实现单头 SASRec。代码对应上述论文公式,包含可学习位置向量、因果掩码、Padding 掩码、Pre-LN 残差块、共享物品 Embedding 和采样 BCE。
这里采用便于理解的 Pre-LN 实现。TensorFlow 参考实现在注意力中对 Query 使用归一化输入、Key/Value 使用子层原输入,并有输入向量缩放和不同的残差、Dropout 放置细节;下文统一采用上述 Pre-LN 表达,未加入输入向量缩放,并在末尾增加 LayerNorm。复现实验表格时应以参考实现及对应超参数为准。
(1)因果自注意力模块
import math
import torch
import torch.nn as nn
import torch.nn.functional as F
class SASRecBlock(nn.Module):
def __init__(self, dim, dropout=0.2):
super().__init__()
self.attn_norm = nn.LayerNorm(dim)
self.ffn_norm = nn.LayerNorm(dim)
self.qkv = nn.Linear(dim, 3 * dim, bias=False)
self.ffn = nn.Sequential(
nn.Linear(dim, dim),
nn.ReLU(),
nn.Linear(dim, dim),
)
self.dropout = nn.Dropout(dropout)
def forward(self, x, valid):
# x: [B, N, D]; valid: [B, N]
_, length, dim = x.shape
z = self.attn_norm(x)
q, k, v = self.qkv(z).chunk(3, dim=-1)
logits = q @ k.transpose(-1, -2) / math.sqrt(dim)
causal = torch.ones(
length, length, device=x.device, dtype=torch.bool
).tril()
allowed = causal.unsqueeze(0) & valid.unsqueeze(1)
# 有效 Query 至少能看到自己;Padding Query 可能整行不可见。
logits = logits.masked_fill(
~allowed, torch.finfo(logits.dtype).min
)
weights = torch.softmax(logits, dim=-1)
# 全掩码行的 Softmax 暂时是均匀分布;这里将其全部清零。
weights = weights.masked_fill(~allowed, 0.0)
attended = weights @ v
x = x + self.dropout(attended)
x = x + self.dropout(self.ffn(self.ffn_norm(x)))
return x.masked_fill(~valid.unsqueeze(-1), 0.0)
allowed 同时限制未来位置和补零 Key。由于这里使用有限的最小值并在 Softmax 后再次清零,完全没有可见 Key 的行不会产生 NaN;这些无效 Query 的最终输出也会被置零。
(2)SASRec 模型与训练目标
class SASRec(nn.Module):
def __init__(self, num_items, max_len=50, dim=64,
num_blocks=2, dropout=0.2):
super().__init__()
self.max_len = max_len
self.item_embedding = nn.Embedding(
num_items + 1, dim, padding_idx=0
)
self.position_embedding = nn.Embedding(max_len, dim)
self.dropout = nn.Dropout(dropout)
self.blocks = nn.ModuleList([
SASRecBlock(dim, dropout) for _ in range(num_blocks)
])
self.final_norm = nn.LayerNorm(dim)
def forward(self, items):
# items: 左侧补零的物品 ID,形状 [B, N]
length = items.size(1)
if not 1 <= length <= self.max_len:
raise ValueError("输入长度必须在 1 到 max_len 之间")
valid = items.ne(0)
positions = torch.arange(length, device=items.device)
x = self.item_embedding(items)
x = self.dropout(x + self.position_embedding(positions))
x = x.masked_fill(~valid.unsqueeze(-1), 0.0)
for block in self.blocks:
x = block(x, valid)
x = self.final_norm(x)
return x.masked_fill(~valid.unsqueeze(-1), 0.0)
def sampled_loss(self, items, positives, negatives):
h = self(items)
valid = items.ne(0) & positives.ne(0)
if not valid.any():
raise ValueError("批次中至少需要一个有效训练位置")
if (negatives[valid] == 0).any():
raise ValueError("有效位置的负例不能是 Padding")
if (negatives[valid] == positives[valid]).any():
raise ValueError("正负样本不能相同")
pos_logits = (h * self.item_embedding(positives)).sum(-1)
neg_logits = (h * self.item_embedding(negatives)).sum(-1)
loss = F.softplus(-pos_logits) + F.softplus(neg_logits)
return loss[valid].mean()
def score_candidates(self, items, candidates):
# candidates: [C],所有用户共享同一候选集合
if not items[:, -1].ne(0).all():
raise ValueError("推理输入必须非空并采用左侧补零")
if (candidates == 0).any():
raise ValueError("候选物品不能包含 Padding")
h = self(items)[:, -1, :] # [B, D]
return h @ self.item_embedding(candidates).T # [B, C]
sampled_loss 只在有效位置上取均值;score_candidates 使用最后一列表示进行推荐。训练器还应保证负例不在该用户的训练交互集合中,下面给出一个小规模演示。
(3)样本构造、训练与推理
def make_example(history, num_items, max_len):
# history 只能包含训练阶段已知的交互,ID 范围为 1..num_items。
if len(history) < 2:
raise ValueError("训练至少需要两次交互")
if max_len < 1 or any(i < 1 or i > num_items for i in history):
raise ValueError("序列长度或物品 ID 无效")
inputs = history[:-1][-max_len:]
positives = history[1:][-max_len:]
seen = set(history)
pool = [i for i in range(1, num_items + 1) if i not in seen]
if not pool:
raise ValueError("没有可采样的负物品")
choice = torch.randint(len(pool), (len(inputs),)).tolist()
negatives = [pool[i] for i in choice]
pad = [0] * (max_len - len(inputs))
return tuple(torch.tensor(pad + values, dtype=torch.long)
for values in (inputs, positives, negatives))
torch.manual_seed(42)
num_items, max_len = 20, 5
histories = [[4, 7, 2, 9], [3, 8, 6, 1, 5, 10, 12]]
examples = [make_example(h, num_items, max_len) for h in histories]
items, positives, negatives = [torch.stack(x) for x in zip(*examples)]
model = SASRec(num_items, max_len, dim=32, num_blocks=2)
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
model.train()
loss = model.sampled_loss(items, positives, negatives)
optimizer.zero_grad()
loss.backward()
optimizer.step()
print("Training loss:", loss.item())
# 推理时可以使用截至此刻的全部已知历史,包括训练输入的最后目标。
inference_items = []
for history in histories:
tail = history[-max_len:]
inference_items.append([0] * (max_len - len(tail)) + tail)
inference_items = torch.tensor(inference_items, dtype=torch.long)
candidates = torch.arange(1, num_items + 1)
model.eval()
with torch.no_grad():
scores = model.score_candidates(inference_items, candidates)
# 本例采用“不推荐已交互物品”的业务规则。
for row, history in enumerate(histories):
scores[row, torch.tensor(sorted(set(history))) - 1] = -torch.inf
top_items = candidates[scores.topk(k=3, dim=-1).indices]
print("Top-3 item IDs:", top_items)
示例只演示一次训练更新,推荐结果不代表模型已经学到有效偏好。make_example 枚举整个物品集合生成负例池,仅适用于小规模演示;实际大规模训练应使用更高效的采样器,并在训练过程中重新采样负例。
3.2 实验与工程注意事项
- 按时间构造数据:先划分训练、验证、测试,再生成训练样本。验证、测试时只提供预测时刻之前的历史,不能随机打散后让未来行为进入输入。
- 区分采样评估与全量评估:SASRec 的基准实验采用留出后续交互并与采样负例排序的协议,报告 HR、NDCG。其数值不能直接与全量物品检索的 Recall、NDCG 比较;候选集、过滤规则和负例数量都应随实验一起记录。
- 控制序列长度:最大长度
- 区分基线与改造:多头数量、FFN 隐藏维度、归一化位置、损失函数与负采样策略都会影响结果。使用通用 Transformer 模块替换时,应明确它与原始 SASRec 的差异。
- 补齐异常输入处理:全 Padding 序列不应参与推荐;没有可用负例、没有有效监督位置、候选数量不足等情况应单独处理。
4. 总结
SASRec 将用户历史组织成带顺序的输入,通过因果自注意力学习不同历史行为的贡献,再利用逐位置前馈网络和共享物品 Embedding 完成下一物品预测。它的关键不仅是使用 Attention,更是让输入错位、因果掩码、补零处理和采样训练目标共同对应同一个预测任务。
与固定用户向量相比,SASRec 的表示随近期历史变化;与逐步递推的序列模型相比,它允许训练位置并行计算。但标准全注意力仍有平方级的序列长度成本,纯 ID 表示也不能直接解决新物品冷启动。
理解 SASRec 后,可以进一步比较双向掩码训练的 BERT4Rec,或阅读本站的 CCFormer,继续讨论长行为序列上的表示能力与计算效率。
5. 参考文献
[1] Kang W C, McAuley J. Self-Attentive Sequential Recommendation. ICDM, 2018.
[2] Vaswani A, Shazeer N, Parmar N, et al. Attention Is All You Need. NeurIPS, 2017.
[3] Sun F, Liu J, Wu J, et al. BERT4Rec: Sequential Recommendation with Bidirectional Encoder Representations from Transformer. CIKM, 2019.