CCFormer:腾讯工业推荐中的高效长序列建模
总阅读量 加载中... 次
CCFormer 的预印本于 2026 年公开,题为 CCFormer: Efficient Cross-Field Interaction and Hierarchical Sequence Compression for Industrial Recommendation at Tencent [1]。模型面向工业精排,将跨特征域交互、局部行为混合和分层压缩组合为长序列建模骨干。
用户画像与候选物品负责发起查询,历史行为提供上下文;序列内部使用局部子空间混合,再通过卷积逐层缩短。这样的结构避免对全部历史行为执行全局两两注意力,同时保留多层次的行为表示。
1. 背景
长历史可以提供更丰富的兴趣证据,但标准自注意力需要构建长度平方规模的相关性矩阵。直接截断历史可能丢失长期偏好,提前把整段历史压成单个向量又可能损失候选相关的细粒度交互。
推荐输入还包含语义不同的字段:用户画像描述稳定属性,历史行为提供兴趣上下文,候选物品代表当前需要评分的对象。将所有词元统一放入全局自注意力,既增加计算,也未必符合这些字段的作用。
CCFormer 将交互拆成两部分:少量用户与候选词元读取长历史,行为词元在局部子空间中混合。分层压缩再逐步降低后续层处理的历史长度。
2. 模型架构
2.1 整体结构
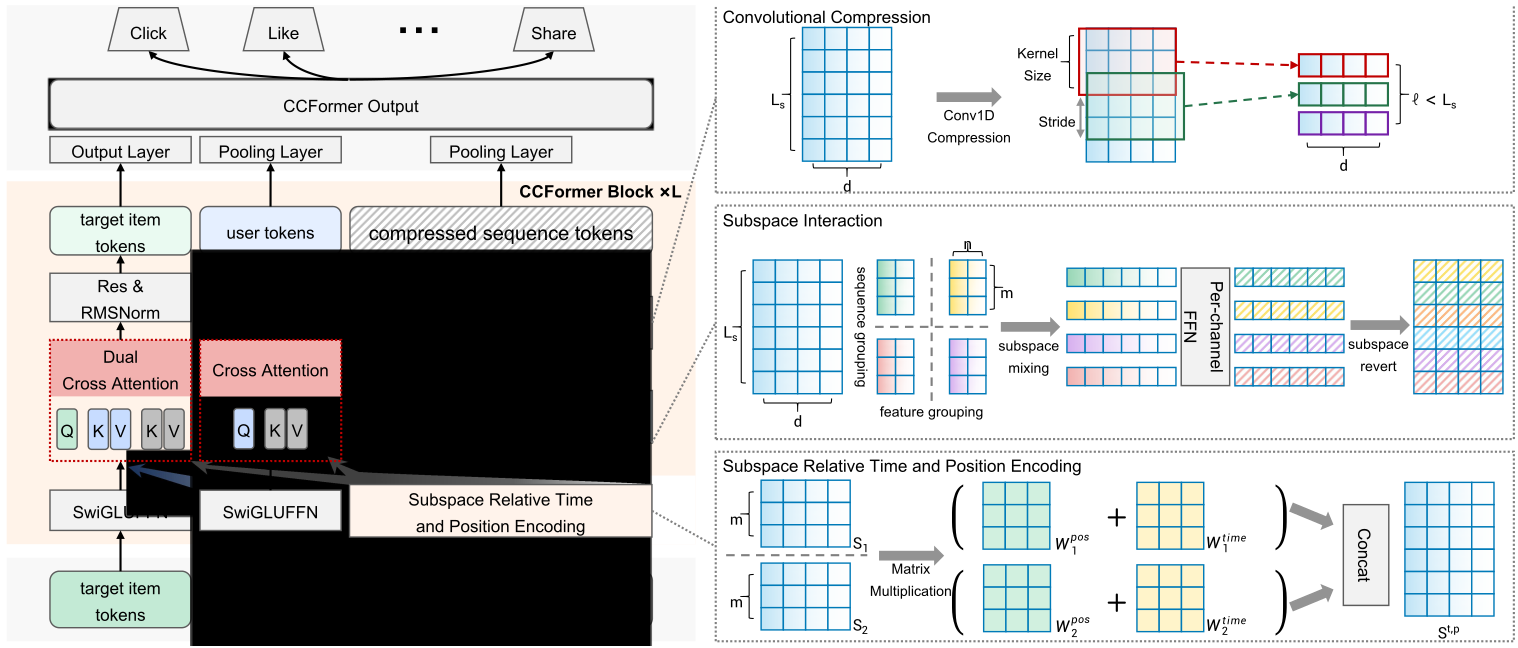
CCFormer架构图
输入分为用户、行为和目标三个域:
用户侧异构字段投影为少量词元,每个行为与候选物品保留物品级表示。多个交互块更新三个域,最终归一化表示经输出与池化处理后,进入点击、点赞和分享等任务头。
每个交互块包含字段分离交叉注意力、相对时间位置编码、子空间混合及卷积压缩。用户与目标更新还结合残差和均方根归一化,不能把整体简化成一条只处理行为序列的流水线。
2.2 字段分离交叉注意力
用户与目标先分别经过逐词元门控前馈网络:
用户生成查询、键和值,序列只提供键和值:
目标使用两组独立查询投影:
以多头注意力的单头形式表示:
三条查询关系为:
箭头表示查询域到上下文域,输出长度由查询决定,不代表更新所有被查询的行为词元。目标的两路输出拼接后投影,用户的输出单独投影:
行为查询需要过滤补零位置。完全空历史还需显式返回零上下文,避免对全被屏蔽的得分直接归一化。
2.3 局部相对时间与位置
将行为按连续的
时间差越大,时间分量越小。时间戳单位会改变衰减尺度,训练和服务必须使用相同单位。
相对位置矩阵由偏移索引查表得到:
局部行为更新为:
这里是关系矩阵与行为表示相乘,不是对注意力得分增加偏置,也没有要求两种权重经过概率归一化。位置项可以为负,不能把最终矩阵整体解释为随时间单调衰减的注意力概率。
2.4 子空间词元混合
对
每个子向量包含
第
参数在不同局部时间组之间共享,但在通道组之间独立。输出再恢复为原始序列布局。局部混合本身不构成任意远距离行为间的全局交互,更大范围的表示聚合依赖后续层与卷积压缩。
2.5 分层卷积压缩
混合后的序列沿时间轴执行一维卷积:
卷积核宽度
仅考虑连续卷积、核宽 3、步长 2 时,感受野依次为
补零位置进入卷积前需要清零,压缩后也要更新有效位置掩码。无效输出必须再次清零,避免卷积偏置或相邻表示使补零位置变成可查询内容。
2.6 复杂度与候选并行
忽略投影维度因子,交叉注意力的相关性计算为:
固定
若子空间门控隐藏宽度为
目标词元只作为查询,且不互相注意,使同一用户的多个候选可以共享用户和历史路径。服务时还需要保证逐候选前馈和任务头不跨候选混合,候选数量增长也仍会增加目标查询成本。
3. 核心模块实现
3.1 相对时间位置编码
PyTorch 示例聚焦局部时间位置、独立通道组混合及掩码压缩。输入已完成物品嵌入;时间已转换为统一的浮点时间单位,掩码为布尔类型。
import math
import torch
from torch import nn
from torch.nn import functional as F
class LocalTimePosition(nn.Module):
def __init__(self, group_size=4, beta=0.9):
super().__init__()
if group_size < 1 or not 0 < beta < 1:
raise ValueError("invalid temporal parameters")
self.group_size = group_size
self.log_beta = math.log(beta)
self.raw_alpha = nn.Parameter(torch.zeros(()))
self.raw_gamma = nn.Parameter(torch.zeros(()))
self.position = nn.Parameter(torch.zeros(2 * group_size - 1))
def forward(self, sequence, timestamps, mask):
batch, length, dim = sequence.shape
m = self.group_size
if length % m:
raise ValueError("sequence length must be divisible by group_size")
grouped = sequence.reshape(batch, length // m, m, dim)
times = timestamps.reshape(batch, length // m, m)
valid = mask.reshape(batch, length // m, m)
delta = (times.unsqueeze(-1) - times.unsqueeze(-2)).abs()
alpha = F.softplus(self.raw_alpha)
gamma = F.softplus(self.raw_gamma)
powered = delta.clamp_min(1e-6).pow(gamma)
powered = torch.where(delta == 0, torch.zeros_like(powered), powered)
temporal = alpha * torch.exp(self.log_beta * powered)
index = torch.arange(m, device=sequence.device)
relative = index[:, None] - index[None, :] + m - 1
weights = temporal + self.position[relative]
pair_mask = valid.unsqueeze(-1) & valid.unsqueeze(-2)
weights = weights * pair_mask
result = weights @ (grouped * valid.unsqueeze(-1))
return result.reshape_as(sequence) * mask.unsqueeze(-1)
正参数通过平滑正值映射约束,零时间差单独处理,避免对可学习幂在零点求导产生不稳定值。长度不足整组时,应先补齐数据和掩码,并在后续处理中保留无效标记。
3.2 独立通道组门控混合
class SubspaceMixing(nn.Module):
def __init__(self, dim, group_size=4, channel_width=2, expansion=2):
super().__init__()
if min(dim, group_size, channel_width, expansion) < 1 or dim % channel_width:
raise ValueError("invalid subspace dimensions")
self.dim, self.m, self.n = dim, group_size, channel_width
self.groups = dim // channel_width
width = group_size * channel_width
self.networks = nn.ModuleList([
nn.ModuleList([
nn.Linear(width, expansion * width, bias=False),
nn.Linear(width, expansion * width, bias=False),
nn.Linear(expansion * width, width, bias=False),
]) for _ in range(self.groups)
])
def forward(self, sequence, mask):
batch, length, dim = sequence.shape
if dim != self.dim or length % self.m:
raise ValueError("invalid sequence dimensions")
clean = sequence * mask.unsqueeze(-1)
grouped = clean.reshape(batch, length // self.m, self.m, self.groups, self.n)
grouped = grouped.permute(0, 1, 3, 2, 4).reshape(
batch, length // self.m, self.groups, self.m * self.n
)
outputs = []
for c, (gate, value, output) in enumerate(self.networks):
x = grouped[:, :, c]
outputs.append(output(F.silu(gate(x)) * value(x)))
restored = torch.stack(outputs, dim=2).reshape(
batch, length // self.m, self.groups, self.m, self.n
).permute(0, 1, 3, 2, 4).reshape_as(sequence)
return restored * mask.unsqueeze(-1)
不同通道组使用不同参数,行为组之间共享同一组网络。示例选择 SiLU 门激活;输出重新应用掩码,防止局部混合将有效信息写到补零位置。
3.3 掩码压缩与运行示例
class MaskedCompression(nn.Module):
def __init__(self, dim):
super().__init__()
self.conv = nn.Conv1d(dim, dim, kernel_size=3, stride=2, padding=1)
def forward(self, sequence, mask):
clean = sequence * mask.unsqueeze(-1)
result = self.conv(clean.transpose(1, 2)).transpose(1, 2)
compressed_mask = F.max_pool1d(
mask[:, None].to(sequence.dtype), kernel_size=3,
stride=2, padding=1,
).squeeze(1).bool()
return result * compressed_mask.unsqueeze(-1), compressed_mask
torch.manual_seed(42)
sequence = torch.randn(2, 8, 8, requires_grad=True)
mask = torch.tensor([[True] * 5 + [False] * 3, [False] * 8])
timestamps = torch.arange(8, dtype=torch.float32).repeat(2, 1)
time_position = LocalTimePosition(group_size=4)
mixing = SubspaceMixing(dim=8, group_size=4, channel_width=2)
compression = MaskedCompression(dim=8)
encoded = time_position(sequence, timestamps, mask)
mixed = mixing(encoded, mask)
compressed, compressed_mask = compression(mixed, mask)
compressed.square().mean().backward()
print("compressed_shape:", tuple(compressed.shape))
print("empty_history_zero:", compressed[1].abs().sum().item() == 0)
print("finite_gradient:", torch.isfinite(sequence.grad).all().item())
压缩形状为 (2,4,8),全空历史输出为零。压缩掩码表示卷积窗口是否覆盖有效输入,并不意味着每个位置对应同样数量的真实行为。
这些模块覆盖序列路径的关键变换,没有实现完整稀疏特征接入、多头跨域更新、多任务头与工业训练系统。多层使用时,还需为压缩后的词元定义时间代表值和分组补齐策略;示例不把一种自选时间聚合规则冒充模型的唯一设定。
3.4 结果与实现边界
公开报告的工业实验中,相对 HSTU 的训练吞吐量为
压缩和局部混合降低计算,但不会消除特征传输、嵌入存储和服务批处理成本。评价时应固定序列长度、隐藏维度、候选数与资源预算,同时观察精度、吞吐量和延迟。
4. 总结
CCFormer 将用户、历史和候选分成不同语义域,以定向交叉注意力完成兴趣读取,再通过局部时间位置关系、通道组门控混合和卷积压缩处理长行为序列。
效率来自交互路径与计算规模的共同约束。固定查询词元数量和局部分组大小时,主要序列处理可避免长度平方开销;可靠实现还需要明确重排顺序、空历史、压缩掩码与多层时间语义。
5. 参考文献
[1] Wang Y, Zhang H, Hu H, et al. CCFormer: Efficient Cross-Field Interaction and Hierarchical Sequence Compression for Industrial Recommendation at Tencent. arXiv:2607.28070, 2026.
[2] Zhang B, Sennrich R. Root Mean Square Layer Normalization. NeurIPS, 2019, 32.