DIN:深度兴趣网络
总阅读量 加载中... 次
DIN(Deep Interest Network)发表于 KDD 2018,论文题为 Deep Interest Network for Click-Through Rate Prediction [1]。
DIN 的核心思想是根据候选物品,对用户历史行为进行局部兴趣激活。同一份历史面对不同候选物品时,生成不同的兴趣表示,再与用户、候选物品和上下文特征共同预测点击率。
1. 背景
常见的嵌入与多层感知机模型,先将历史物品转换为向量,再通过求和或平均池化得到用户表示:
这种表示不依赖当前候选物品。例如,一个用户同时浏览运动鞋、键盘和小说,候选物品是篮球鞋时,与运动相关的历史通常更值得关注;候选物品换成鼠标,相关历史也随之改变。
问题并不是固定维度向量必然不能表达多种兴趣,而是在聚合历史时没有使用候选物品信息。DIN 仍然输出固定维度的向量,但让其内容随候选物品变化,减少无关行为对当前预测的干扰。
2. 模型架构
2.1 整体网络结构
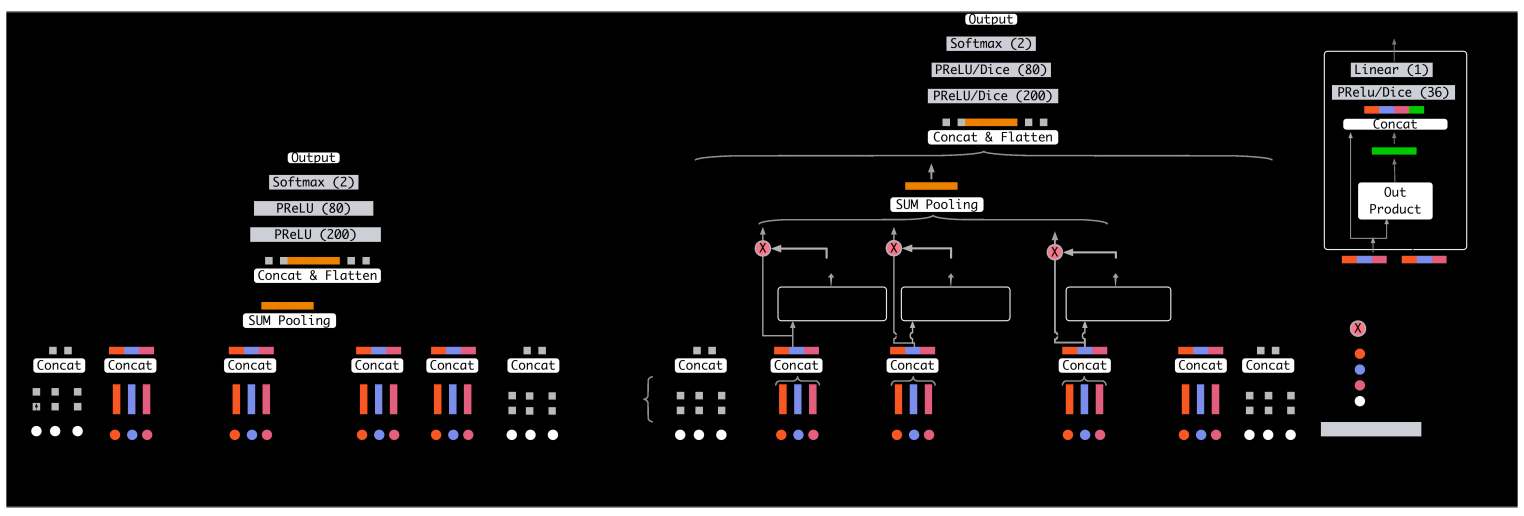
DIN架构图
图中左侧是基础模型,中间是 DIN,右侧展示兴趣激活单元。DIN 保留嵌入与多层感知机的主体结构,将历史行为的普通求和池化替换为候选物品相关的加权求和。
计算流程包括四步:
- 对用户、历史行为、候选物品和上下文特征进行编码。
- 将候选物品分别与各条有效历史行为送入共享的兴趣激活单元。
- 对历史向量加权求和,得到当前候选物品对应的用户兴趣。
- 拼接兴趣表示与其他特征,通过预测网络输出点击概率。
2.2 输入层
设候选物品向量为
历史物品与候选物品的同类字段可以共享嵌入表,使相同物品具有一致的基础表示。用户属性和上下文特征在编码后送入最终预测网络。
一个批次中,历史通常补齐到统一长度。定义有效位置掩码:
其中
2.3 局部兴趣激活
(1)候选物品相关的加权求和
DIN 为每个历史行为计算一个标量激活值:
所有位置共享同一个函数
激活单元使用前馈网络处理候选与历史的组合特征。下面实现采用常见的四段拼接形式:
这里
(2)为什么不使用序列维度的归一化
DIN 不要求
例如,在激活函数固定时,将同一条历史重复两次,对应贡献为
这不意味着“点击越多,兴趣一定越强”,也不保证权重为正。下面使用线性输出得到激活值,不额外添加 Sigmoid、指数变换或 Softmax。因此,激活值是可学习的加权系数,不是概率,也不能直接解释为因果重要性。
(3)掩码与空历史
对未归一化的权重,应将无效位置置零。把权重设为负无穷只适用于随后做 Softmax 的部分实现;若直接参与加权求和,会导致错误结果。
空历史对应
2.4 数据自适应激活函数
Dice 根据输入分布平滑地混合两条分支:
其中
下文明确采用如下统计约定:训练时对有效输入行计算每个通道的均值与方差,并更新滑动统计量;推理时使用滑动统计量。若训练输入仅有一行,则使用已有滑动统计量,避免单样本方差退化。该约定是示例的实现选择,真实业务应结合批量大小验证。
2.5 预测层与损失函数
将兴趣表示与其他特征拼接:
训练目标为二元交叉熵:
架构图中的二分类 Softmax 与单分数 Sigmoid 都可以表达二分类概率。下面采用单分数输出,并使用 BCEWithLogitsLoss,避免在计算损失前重复执行 Sigmoid。
2.6 小批量感知正则化
大规模嵌入表中,一个批次通常只访问少量条目。若每一步都显式计算整个表的 L2 惩罚,就会增加对未访问条目的计算和更新开销。小批量感知正则化将计算限制在本批出现的特征上。
设
若
近似发生在“将出现次数替换为是否出现”这一步。同一特征在一个批次的多个样本中出现时,两者不再相等;训练过程中参数还会不断变化,因此不能把逐批更新视为与全表 L2 完全相同的优化过程。
实际实现需要统一频次统计、样本内去重与批内去重的口径,并将频次限制在训练集内统计。惩罚项的缩放还要与批次平均损失及正则化系数协调。下面训练示例只包含交叉熵,不用普通 weight_decay 冒充该正则化方法。
2.7 模型能力与局限
DIN 建模的是候选物品与历史行为之间的相关性。基础结构没有循环状态、位置编码或行为间自注意力;在固定参数和统计量下,同步排列历史与掩码,不改变加权和。因此它不能仅凭列表位置区分“先买鞋后买袜子”和“先买袜子后买鞋”。
这为后续兴趣演化模型提供了切入点:除了哪些行为相关,还可以进一步建模兴趣如何变化。已有的 SASRec 则通过因果自注意力建模序列,任务与候选物品参与方式也与 DIN 不同。
同一用户的不同候选物品需要分别计算兴趣激活。若激活网络宽度固定,计算成本随候选数量和历史长度近似线性增加;这也是长序列场景需要检索、压缩或缓存机制的原因之一。
3. 模型实现
3.1 核心代码实现
下面给出可运行的 PyTorch 示例,包含自定义 Dice、兴趣激活、完整预测模型和一次训练更新。为突出核心机制,只使用用户 ID、物品 ID 和历史物品 ID,不额外加入类别、店铺与上下文。
(1)数据自适应激活函数
import torch
import torch.nn as nn
class Dice(nn.Module):
def __init__(self, width, eps=1e-8, momentum=0.1):
super().__init__()
self.alpha = nn.Parameter(torch.zeros(width))
self.register_buffer("running_mean", torch.zeros(width))
self.register_buffer("running_var", torch.ones(width))
self.eps, self.momentum = eps, momentum
def forward(self, x):
# 输入为 [有效行数, 通道数]。
if self.training and x.shape[0] > 1:
mean = x.mean(dim=0)
var = x.var(dim=0, unbiased=False)
with torch.no_grad():
self.running_mean.lerp_(mean.detach(), self.momentum)
self.running_var.lerp_(var.detach(), self.momentum)
else:
mean, var = self.running_mean, self.running_var
gate = torch.sigmoid((x - mean) / torch.sqrt(var + self.eps))
return gate * x + (1 - gate) * self.alpha * x
(2)兴趣激活与掩码池化
class InterestPooling(nn.Module):
def __init__(self, dim):
super().__init__()
self.activation = nn.Sequential(
nn.Linear(4 * dim, 80), Dice(80),
nn.Linear(80, 40), Dice(40), nn.Linear(40, 1),
)
def forward(self, query, keys, mask):
# query: [B, D], keys: [B, T, D], mask: [B, T]
expanded = query[:, None, :].expand_as(keys)
q, k = expanded[mask], keys[mask]
weights = keys.new_zeros(mask.shape)
if k.shape[0] > 0:
features = torch.cat([q, k, q - k, q * k], dim=-1)
scores = self.activation(features).squeeze(-1)
weights = weights.masked_scatter(mask, scores)
# 无效权重为零,不执行 Softmax 或 Sigmoid。
interest = (weights.unsqueeze(-1) * keys).sum(dim=1)
return interest, weights
有效行筛选同时保护了 Dice 统计量和最终池化。全批历史为空时跳过激活网络,输出零兴趣向量。
(3)完整预测模型
class DIN(nn.Module):
def __init__(self, num_users, num_items, dim=16):
super().__init__()
self.user_embedding = nn.Embedding(num_users, dim)
# 物品 ID 0 专用于补零,真实物品 ID 从 1 开始。
self.item_embedding = nn.Embedding(num_items + 1, dim, padding_idx=0)
self.pooling = InterestPooling(dim)
self.predictor = nn.Sequential(
nn.Linear(3 * dim, 200), Dice(200),
nn.Linear(200, 80), Dice(80), nn.Linear(80, 1),
)
def forward(self, users, targets, history, lengths):
if history.ndim != 2 or lengths.shape != (history.shape[0],):
raise ValueError("history 应为 [B, T],lengths 应为 [B]")
if torch.any(lengths < 0) or torch.any(lengths > history.shape[1]):
raise ValueError("历史长度超出有效范围")
mask = torch.arange(history.shape[1], device=history.device)[None, :] < lengths[:, None]
# 先清除无效位置,避免补零区中的任意 ID 参与嵌入查表。
keys = self.item_embedding(history.masked_fill(~mask, 0))
query = self.item_embedding(targets)
interest, _ = self.pooling(query, keys, mask)
features = torch.cat([self.user_embedding(users), query, interest], dim=-1)
return self.predictor(features).squeeze(-1)
输入 ID 与长度使用整数张量,并与模型位于同一设备。有效历史和候选物品 ID 必须在 1..num_items 范围内;新用户、新物品应分配独立的未知类别 ID,不能与补零 ID 混用。
(4)前向预测与训练示例
torch.manual_seed(42)
model = DIN(num_users=10, num_items=100, dim=8)
users = torch.tensor([0, 1, 2, 3])
targets = torch.tensor([5, 12, 30, 8])
history = torch.tensor([
[1, 2, 3, 0],
[10, 11, 0, 0],
[0, 0, 0, 0],
[4, 5, 6, 7],
])
lengths = torch.tensor([3, 2, 0, 4])
labels = torch.tensor([1., 0., 1., 0.])
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
model.train()
logits = model(users, targets, history, lengths)
loss = nn.BCEWithLogitsLoss()(logits, labels)
optimizer.zero_grad()
loss.backward()
optimizer.step()
model.eval()
with torch.no_grad():
probabilities = torch.sigmoid(model(users, targets, history, lengths))
print("Prediction shape:", probabilities.shape)
print("Training loss:", loss.item())
示例包括一个空历史用户,用于检查边界处理。模拟数据只验证计算流程,不代表真实 CTR 效果;训练时 Dice 使用批次统计量,线上预测需要切换到 eval()。
3.2 实验与工程注意事项
- 检验候选相关性:固定历史、更换候选物品,观察兴趣表示是否变化,并与普通求和池化基线比较。
- 验证补零不影响结果:增加补零长度不应改变有效激活值和预测。含统计量的网络要同时检查训练与推理模式。
- 控制历史时间边界:训练样本只能使用曝光前的历史。离线评估应遵循实际服务中的截断、去重与行为类型筛选规则。
- 区分模型分数与解释:激活值可能为负,也受嵌入尺度与后续网络影响,不应直接作为用户偏好的概率。
- 检查服务成本:候选数量、历史长度和激活网络宽度共同决定延迟。需要评估批量计算与嵌入复用,而不只统计模型参数量。
4. 总结
DIN 将候选物品信息引入历史聚合过程,使用户兴趣表示随当前预测目标变化。局部激活、未归一化加权求和、Dice 与小批量感知正则化分别解决相关性建模、表示尺度、激活函数适应性及稀疏参数训练成本问题。
它的重点是“哪些历史与当前候选相关”,基础结构并不显式描述兴趣演化。理解这一边界,有助于进一步阅读 DIEN、会话兴趣建模和长序列推荐模型。
5. 参考文献
[1] Zhou G, Song C, Zhu X, et al. Deep Interest Network for Click-Through Rate Prediction. KDD, 2018.
[2] He K, Zhang X, Ren S, Sun J. Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification. ICCV, 2015.
[3] Zhou G, Mou N, Fan Y, et al. Deep Interest Evolution Network for Click-Through Rate Prediction. AAAI, 2019.