协同过滤推荐系统中矩阵分解
总阅读量 加载中... 次
1 背景
在现代工业级推荐系统中,如何从海量信息中精准捕捉用户偏好是核心的研究课题。推荐系统的形式化定义通常聚焦于用户集合
早期的推荐系统主要依赖于基于邻域的协同过滤(Collaborative Filtering, CF)算法(包括基于用户 User-CF 和基于物品 Item-CF)。该范式通过在观测空间中直接计算余弦相似度或皮尔逊相关系数来寻找最近邻。然而,随着互联网业务规模的爆发,邻域模型在实际应用中遭遇了严峻的学术与工程瓶颈:
- 高度稀疏性(Data Sparsity):由于用户主动交互的物品数远小于系统的总物品量,矩阵
- 可扩展性瓶颈(Scalability Bottleneck):随着用户维度
为了打破这种“既存不下,又算不动”的限制,矩阵分解(Matrix Factorization, MF)技术应运而生。作为一种基于低秩近似(Low-Rank Approximation)的方法,它放弃了直接在稀疏的高维观测空间中计算关联,转而将高维稀疏矩阵映射至低维连续的隐向量空间(Latent Space),通过重构用户和物品的隐特征来预测未知的交互行为。这一技术的提出,不仅有效缓解了数据稀疏性问题,也奠定了现代推荐系统表征学习的基础。
2 矩阵分解基本原理
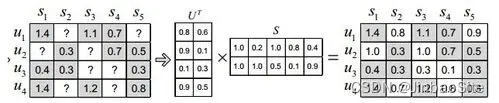
矩阵分解基本原理:将
其中,
-
-
-
-
-
基于该表征,用户
通过这一映射机制,原始矩阵中的缺失值预测问题被优雅地转化为几何空间中的向量内积计算。
那么矩阵分解的推荐算法为:根据User-Item共现矩阵进行矩阵分解得到用户隐向量矩阵和物品隐向量矩阵,计算用户与未交互物品的预测得分,根据预测得分排序给用户推荐物品。
3 算法实现
求解低秩矩阵
3.1 目标函数定义
为了使预测评分
-
-
-
3.2 优化求解算法
由于目标函数
A. 随机梯度下降法
SGD 通过逐个或逐批次抽取已知样本,计算当前参数下的预测残差
其中
B. 交替最小二乘法
尽管目标函数非全局凸,但在固定其中一个矩阵时,它对于另一个矩阵是严谨的二次型凸函数。ALS 的核心机制即在于利用这一特性进行多轮交替迭代:
- 固定
- 固定
ALS 的核心工程价值在于:在各行向量的求解更新过程中,计算逻辑保持完全独立。因此,它具备天然的并行计算特性,能够完美契合分布式计算框架(如 Apache Spark MLlib),适用于处理超大规模离线批处理任务。
4 总结
作为协同过滤发展史上的重要里程碑,矩阵分解技术不仅是对传统邻域模型的革新,更为后续表征学习(Representation Learning)的发展奠定了坚实的理论基石。
4.1 核心贡献与理论优势
- 高效的空间表征:将原有的高维稀疏表示压缩为低维稠密向量(即 Embedding 的原型),使得空间复杂度由
- 优异的泛化性能:隐空间的线性重构机制使模型具备了强大的“捕获潜在语义”的能力,有效解决了协同过滤中因冷门物品交互极少导致的“近邻断裂”问题,提高了长尾商品的推荐覆盖率。
- 高可扩展性:在基本 MF 的基础上,极易融入全局偏置(Bias SVD)、时间动态性(TimeSVD++)以及隐式反馈行为,具有极高的工程改造上限。
4.2 局限性分析
- 弱解释性:学出的隐特征维度(Latent Dimension)通常由数据驱动,不具备显式的、人类可读的物理意义,难以进行精细的可解释性白盒分析。
- 难以捕捉非线性与高阶关联:内积(Dot Product)操作本质上是一种简单的双线性组合,无法有效挖掘用户和物品之间复杂的非线性高阶交互(High-order Interactions)及上下文关联(Context-aware)。
4.3 演进脉络与未来展望
伴随着深度学习的兴起,矩阵分解中“将实体映射为稠密低维嵌入向量(Embedding)”的核心思想,已被深度学习推荐模型(如深度匹配双塔模型、神经协同过滤 NCF、以及图神经网络 GNN)完全继承。
尽管经典矩阵分解在应对多维交叉特征时显露疲态,但它作为向量化召回(Vector Retrieval)和表征学习的根基,在现今的工业级级联推荐架构中依然发挥着不可替代的基础性作用。其从“线性低秩拟合”向“非线性深度表征”的过渡,正昭示了推荐系统算法从浅层统计向高阶认知演进的必然趋势。