DSIN:深度会话兴趣网络
总阅读量 加载中... 次
DSIN(Deep Session Interest Network)发表于 IJCAI 2019,论文题为 Deep Session Interest Network for Click-Through Rate Prediction [1]。
DSIN 从会话结构出发建模用户兴趣:同一会话中的行为通常围绕相近意图,不同会话之间则可能发生明显变化。模型先在每个会话内部提取兴趣,再建模多个会话之间的联系,最后根据候选物品激活相关会话兴趣。
1. 背景
DIN 根据候选物品选择相关历史行为,但不显式使用行为顺序;DIEN 用循环网络描述逐行为兴趣演化。二者都把用户历史主要视为一条连续序列。
实际行为往往具有更强的层次结构。例如,用户在十分钟内连续浏览几款跑鞋,数小时后又浏览相机镜头。同一段连续活动内部通常较为同质,不同活动之间则可能代表不同兴趣。若直接在整条序列上建模,模型需要同时学习行为内关系、会话边界和跨会话变化。
DSIN 将问题分成三个层次:
- 会话内哪些行为共同表达本次兴趣;
- 多个会话兴趣如何相互影响并随顺序变化;
- 哪些会话兴趣与当前候选物品相关。
这种结构建立在可靠的会话划分之上。若边界定义与业务行为节奏不匹配,后续网络再复杂也难以恢复正确的层次关系。
2. 模型架构
2.1 整体网络结构
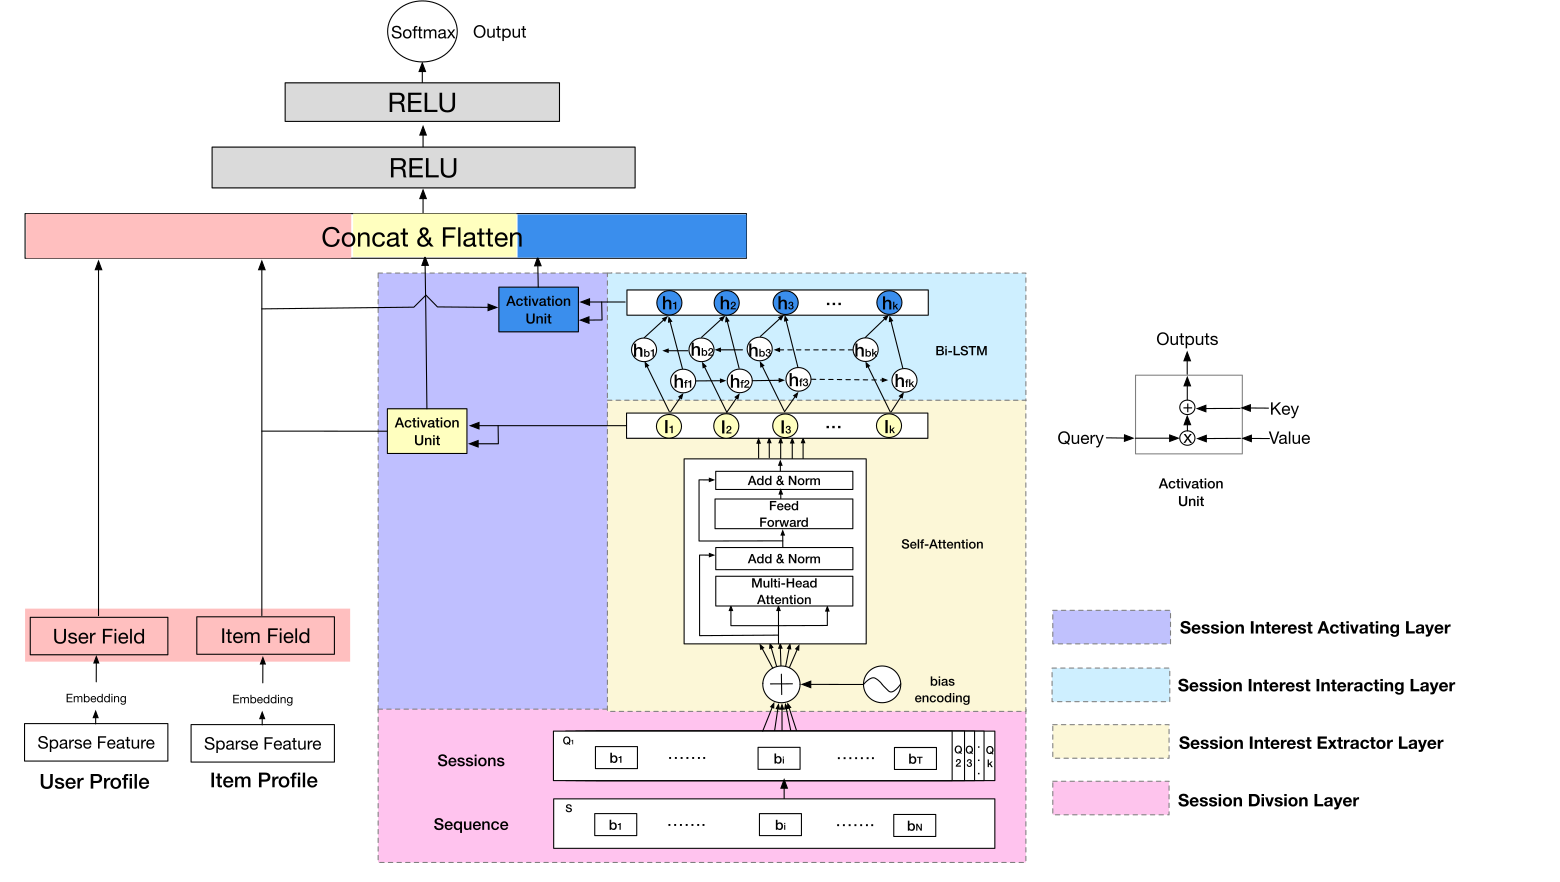
DSIN架构图
DSIN 的用户行为分支由四层组成:
- 会话划分层:按相邻行为时间间隔将历史切分为多个会话。
- 会话兴趣提取层:加入偏置编码,在每个会话内使用多头自注意力和前馈网络。
- 会话兴趣交互层:使用 Bi-LSTM 融合前后会话的上下文。
- 会话兴趣激活层:根据候选物品分别聚合原始会话兴趣和上下文化会话兴趣。
两路兴趣表示与用户特征、候选物品特征拼接后进入预测网络。图中的多个会话共用同一套自注意力参数,避免每个会话拥有独立网络。
2.2 会话划分层
设按时间排序的用户行为序列为:
当相邻行为的时间间隔超过阈值
DSIN 的实验采用 30 分钟作为划分阈值,但它不是普适常数。内容消费、购物和本地服务的行为节奏不同,应根据业务含义与验证结果确定阈值。
批量训练通常将数据补齐为
前者表示有效会话,后者表示会话内有效行为。补零位置不能参与自注意力、平均池化、Bi-LSTM 或目标兴趣激活。
会话构造必须在样本预测时点截断,不能使用曝光后的行为。保留最近还是最早的
2.3 偏置编码
每个行为嵌入有三个位置属性:它属于第几个会话、位于会话内第几个位置,以及向量中的通道位置。DSIN 将三组可学习偏置相加:
其中
这是一种可分解的三维偏置,只需要
偏置只应添加到有效位置。即使后续注意力屏蔽了补零键,若在平均池化时遗漏掩码,带偏置的补零位置仍会污染会话兴趣。
2.4 会话内兴趣提取
(1)多头自注意力
对第
各头输出拼接后进行线性投影:
自注意力让会话内每个行为结合其他行为的信息。例如,一次偶然点击可以根据它与同会话其他行为的关系被弱化。不同注意力头可以学习颜色、类别、价格等不同交互模式,但注意力权重本身仍不能直接解释为因果贡献。
(2)残差、归一化与前馈网络
会话编码采用两个子层:
然后只对有效行为做平均池化:
这里的自注意力只在单个会话内部计算。若每个会话最多
2.5 会话间兴趣交互
得到会话兴趣序列
如果系统需要事件到达时逐条在线更新状态,双向结构无法仅靠上一步状态完成严格增量计算,需要重新编码窗口、缓存会话结果或改用单向结构。这是离线表示能力与在线更新成本之间的取舍。
2.6 候选物品相关的会话激活
设候选物品向量为
对于维度为
两个 Softmax 都只在有效会话上归一化。
这一步与 DIN 的局部激活目标相似,但激活对象由单条行为变为会话级兴趣。DSIN 使用归一化注意力,因此会话数量的信息不会像未归一化加权和那样直接反映在表示尺度中。
2.7 预测层与损失函数
将两路兴趣、用户特征、候选物品特征与上下文特征拼接:
点击率预测使用二元交叉熵:
下面实现只使用用户 ID、候选物品 ID 和会话历史,直接输出 Logits 并配合 BCEWithLogitsLoss。
2.8 与 DIN、DIEN 的区别
| 模型 | 基本建模单元 | 时间关系 | 候选物品参与位置 |
|---|---|---|---|
| DIN | 单条历史行为 | 不显式建模 | 激活历史行为并加权求和 |
| DIEN | 逐行为兴趣状态 | 两层循环网络 | 控制 AUGRU 的状态更新 |
| DSIN | 会话内行为与会话兴趣 | 会话内自注意力、会话间 Bi-LSTM | 分别聚合原始和上下文化会话兴趣 |
DSIN 的优势来自正确的层次结构,而不是简单地把 DIN 的注意力换成 Transformer。它需要额外的会话边界、两级补零与掩码,并承担会话内平方复杂度和跨会话循环计算。
3. 模型实现
3.1 核心代码实现
下面使用 PyTorch 实现偏置编码、会话兴趣提取、Bi-LSTM 和双路候选物品激活。输入会话形状为 [B, K, T],真实物品 ID 从 1 开始,0 专用于补零。
(1)偏置编码与会话兴趣提取
import torch
import torch.nn as nn
from torch.nn.utils.rnn import pack_padded_sequence, pad_packed_sequence
class BiasEncoding(nn.Module):
def __init__(self, max_sessions, max_items, dim):
super().__init__()
self.session_bias = nn.Parameter(torch.zeros(max_sessions))
self.position_bias = nn.Parameter(torch.zeros(max_items))
self.channel_bias = nn.Parameter(torch.zeros(dim))
def forward(self, x, item_mask):
_, sessions, items, dim = x.shape
bias = (
self.session_bias[:sessions][None, :, None, None]
+ self.position_bias[:items][None, None, :, None]
+ self.channel_bias[:dim][None, None, None, :]
)
return (x + bias) * item_mask.unsqueeze(-1)
class SessionInterestExtractor(nn.Module):
def __init__(self, dim, num_heads, feedforward_dim):
super().__init__()
if dim % num_heads != 0:
raise ValueError("dim 必须能被 num_heads 整除")
self.attention = nn.MultiheadAttention(
dim, num_heads, dropout=0.0, batch_first=True
)
self.norm1 = nn.LayerNorm(dim)
self.feedforward = nn.Sequential(
nn.Linear(dim, feedforward_dim), nn.ReLU(),
nn.Linear(feedforward_dim, dim),
)
self.norm2 = nn.LayerNorm(dim)
def forward(self, x, item_mask, session_mask):
batch_size, sessions, items, dim = x.shape
flat_x = x.reshape(batch_size * sessions, items, dim)
flat_item_mask = item_mask.reshape(batch_size * sessions, items)
active = session_mask.reshape(-1)
pooled = x.new_zeros(batch_size * sessions, dim)
if active.any():
values = flat_x[active]
valid = flat_item_mask[active]
attended, _ = self.attention(
values, values, values, key_padding_mask=~valid,
need_weights=False,
)
hidden = self.norm1(values + attended)
hidden = self.norm2(hidden + self.feedforward(hidden))
hidden = hidden * valid.unsqueeze(-1)
pooled[active] = hidden.sum(dim=1) / valid.sum(dim=1, keepdim=True)
return pooled.reshape(batch_size, sessions, dim)
这里只把非空会话送入自注意力,避免一个会话全部为补零时 Softmax 产生 NaN。平均池化也显式除以有效行为数。
(2)会话间交互与目标激活
class SessionInteraction(nn.Module):
def __init__(self, dim):
super().__init__()
self.lstm = nn.LSTM(dim, dim, batch_first=True, bidirectional=True)
def forward(self, interests, num_sessions):
batch_size, max_sessions, dim = interests.shape
contextual = interests.new_zeros(batch_size, max_sessions, 2 * dim)
active = num_sessions > 0
if active.any():
packed = pack_padded_sequence(
interests[active], num_sessions[active].cpu(),
batch_first=True, enforce_sorted=False,
)
packed_output, _ = self.lstm(packed)
output, _ = pad_packed_sequence(
packed_output, batch_first=True, total_length=max_sessions
)
contextual[active] = output
return contextual
class TargetPooling(nn.Module):
def __init__(self, key_dim, target_dim):
super().__init__()
self.target_projection = nn.Linear(target_dim, key_dim, bias=False)
def forward(self, keys, target, session_mask):
projected = self.target_projection(target)
logits = (keys * projected[:, None, :]).sum(dim=-1)
logits = logits.masked_fill(~session_mask, -torch.inf)
weights = torch.zeros_like(logits)
active = session_mask.any(dim=1)
weights[active] = torch.softmax(logits[active], dim=1)
pooled = (weights.unsqueeze(-1) * keys).sum(dim=1)
return pooled, weights
pack_padded_sequence 防止 Bi-LSTM 处理会话补零。两个方向都只能看到预测时点之前收集的历史会话,不包含未来行为。
(3)完整模型
class DSIN(nn.Module):
def __init__(self, num_users, num_items, max_sessions=4,
max_items=5, dim=16, num_heads=4):
super().__init__()
self.max_sessions, self.max_items = max_sessions, max_items
self.user_embedding = nn.Embedding(num_users, dim)
self.item_embedding = nn.Embedding(num_items + 1, dim, padding_idx=0)
self.bias_encoding = BiasEncoding(max_sessions, max_items, dim)
self.extractor = SessionInterestExtractor(dim, num_heads, 4 * dim)
self.interaction = SessionInteraction(dim)
self.raw_pooling = TargetPooling(dim, dim)
self.context_pooling = TargetPooling(2 * dim, dim)
self.predictor = nn.Sequential(
nn.Linear(5 * dim, 128), nn.ReLU(),
nn.Linear(128, 64), nn.ReLU(), nn.Linear(64, 1),
)
def forward(self, users, targets, sessions, session_lengths, num_sessions):
if sessions.ndim != 3:
raise ValueError("sessions 应为 [B, K, T]")
batch_size, count, items = sessions.shape
if count > self.max_sessions or items > self.max_items:
raise ValueError("输入超过模型配置的最大会话数或会话长度")
if session_lengths.shape != (batch_size, count):
raise ValueError("session_lengths 应为 [B, K]")
if num_sessions.shape != (batch_size,):
raise ValueError("num_sessions 应为 [B]")
if torch.any(num_sessions < 0) or torch.any(num_sessions > count):
raise ValueError("有效会话数超出范围")
if torch.any(session_lengths < 0) or torch.any(session_lengths > items):
raise ValueError("会话长度超出范围")
session_mask = torch.arange(count, device=sessions.device)[None, :] < num_sessions[:, None]
item_mask = (
torch.arange(items, device=sessions.device)[None, None, :]
< session_lengths[:, :, None]
) & session_mask[:, :, None]
if torch.any(session_mask & (session_lengths == 0)):
raise ValueError("有效会话的长度必须大于 0")
embedded = self.item_embedding(sessions.masked_fill(~item_mask, 0))
encoded = self.bias_encoding(embedded, item_mask)
interests = self.extractor(encoded, item_mask, session_mask)
contextual = self.interaction(interests, num_sessions)
target = self.item_embedding(targets)
raw_interest, _ = self.raw_pooling(interests, target, session_mask)
context_interest, _ = self.context_pooling(
contextual, target, session_mask
)
features = torch.cat([
self.user_embedding(users), target, raw_interest, context_interest
], dim=-1)
return self.predictor(features).squeeze(-1)
这里的输入应已由数据管道按时间划分并截断。模型根据长度重新生成掩码,不信任补零区域中的 ID,因此额外补齐不会参与计算。
(4)前向预测与训练示例
torch.manual_seed(42)
model = DSIN(
num_users=10, num_items=100, max_sessions=3,
max_items=4, dim=8, num_heads=2,
)
users = torch.tensor([0, 1, 2, 3])
targets = torch.tensor([8, 15, 30, 9])
sessions = torch.tensor([
[[1, 2, 0, 0], [3, 4, 5, 0], [6, 0, 0, 0]],
[[10, 11, 12, 0], [13, 14, 0, 0], [0, 0, 0, 0]],
[[20, 21, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]],
[[0, 0, 0, 0], [0, 0, 0, 0], [0, 0, 0, 0]],
])
session_lengths = torch.tensor([
[2, 3, 1], [3, 2, 0], [2, 0, 0], [0, 0, 0]
])
num_sessions = torch.tensor([3, 2, 1, 0])
labels = torch.tensor([1., 0., 1., 0.])
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
model.train()
logits = model(users, targets, sessions, session_lengths, num_sessions)
loss = nn.BCEWithLogitsLoss()(logits, labels)
optimizer.zero_grad()
loss.backward()
optimizer.step()
model.eval()
with torch.no_grad():
probabilities = torch.sigmoid(
model(users, targets, sessions, session_lengths, num_sessions)
)
print("Prediction shape:", probabilities.shape)
print("Training loss:", loss.item())
示例包含空历史用户,用于验证两级掩码和空会话处理。模拟数据只检查计算流程,不代表真实点击率效果。
3.2 实验与工程注意事项
- 先验证会话边界:对不同阈值统计会话数量、会话长度及行为类别一致性,并抽样检查边界是否符合业务语义。
- 保持截断方向一致:明确保留最近的会话和最近的会话内行为,避免训练、离线评估和服务采用不同规则。
- 逐层做消融实验:比较整序列池化、仅会话内注意力、加入 Bi-LSTM、加入双路激活和偏置编码,确认各模块的实际收益。
- 检查两级掩码:额外补充会话或行为位置不应改变预测;全空会话不能进入自注意力或带掩码 Softmax。
- 评估双向计算约束:Bi-LSTM 适合在请求时编码完整历史窗口。若要求实时增量更新,需要评估重算成本或单向替代方案。
- 控制长会话成本:会话内注意力复杂度随
4. 总结
DSIN 将用户历史组织成“行为—会话—跨会话”三个层次。偏置编码表达会话位置、会话内位置和通道偏移;多头自注意力提取会话兴趣;Bi-LSTM 融合多个会话的上下文;候选物品再分别激活原始与上下文化兴趣。
模型效果依赖的不只是网络结构,也包括会话边界、截断策略和两级掩码。理解这些数据口径,有助于将 DSIN 与逐行为兴趣演化模型、长序列检索模型区分开来。
5. 参考文献
[1] Feng Y, Lv F, Shen W, et al. Deep Session Interest Network for Click-Through Rate Prediction. IJCAI, 2019.
[2] Zhou G, Song C, Zhu X, et al. Deep Interest Network for Click-Through Rate Prediction. KDD, 2018.
[3] Zhou G, Mou N, Fan Y, et al. Deep Interest Evolution Network for Click-Through Rate Prediction. AAAI, 2019.
[4] Vaswani A, Shazeer N, Parmar N, et al. Attention Is All You Need. NeurIPS, 2017.
[5] Graves A, Schmidhuber J. Framewise Phoneme Classification with Bidirectional LSTM and Other Neural Network Architectures. Neural Networks, 2005.