DIEN:深度兴趣演化网络
总阅读量 加载中... 次
DIEN(Deep Interest Evolution Network)发表于 AAAI 2019,论文题为 Deep Interest Evolution Network for Click-Through Rate Prediction [1]。
DIEN 在 DIN 的候选物品相关兴趣建模基础上进一步引入时间顺序。模型先从行为序列中提取每一步的潜在兴趣,再利用候选物品控制兴趣状态的演化,最终用于点击率预测。
1. 背景
DIN 根据候选物品为历史行为分配权重,可以回答“哪些历史行为与当前候选物品相关”。但它对历史向量做加权求和,不显式建模行为发生的先后顺序。
用户兴趣不仅具有多样性,也会随时间发生变化。例如,用户可能先连续浏览摄影器材,随后转向户外装备。只知道哪些行为与候选物品相关,还不足以说明兴趣是增强、减弱还是已经转移。
直接把行为序列输入普通循环网络也存在两个问题:
- 行为是兴趣的外在表现,循环网络的中间状态缺少逐步监督,不一定能形成清晰的兴趣表示。
- 用户同时拥有多种兴趣,而当前预测只需要其中与候选物品相关的演化轨迹。无关兴趣可能干扰最终状态。
DIEN 将这两个问题拆成兴趣提取和兴趣演化两个阶段,并分别用辅助损失与注意力更新机制处理。
2. 模型架构
2.1 整体网络结构
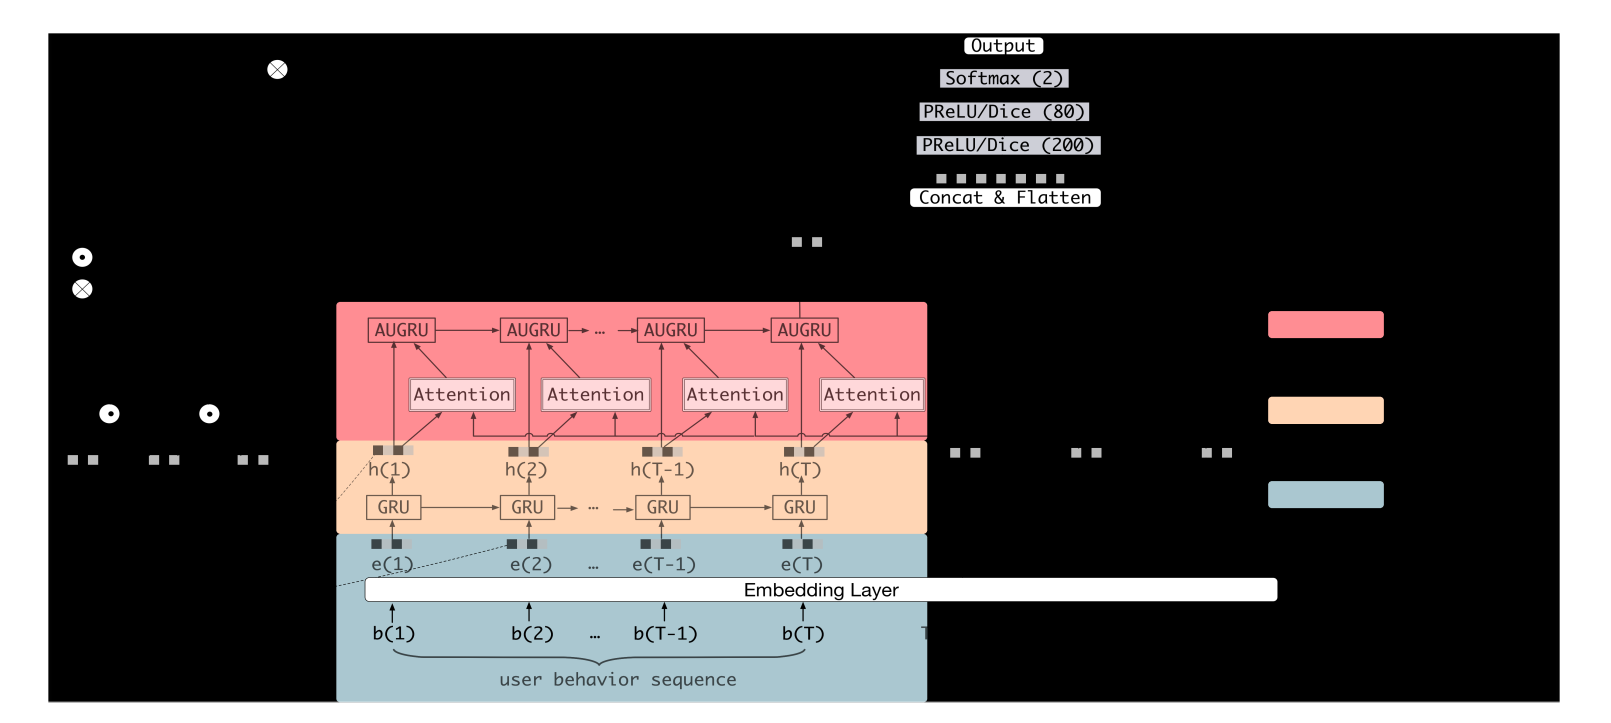
DIEN架构图
模型包含四个主要部分:
- 行为层:按时间排列用户历史行为,并转换为嵌入向量。
- 兴趣提取层:使用 GRU 生成每个时刻的兴趣状态,并以辅助任务提供逐步监督。
- 兴趣演化层:根据候选物品计算各兴趣状态的相关性,通过 AUGRU 控制状态更新。
- 预测层:拼接最终兴趣、候选物品、用户属性和上下文特征,输出点击概率。
设有效历史长度为
2.2 兴趣提取层
兴趣提取层使用 GRU 将行为序列转换为状态序列。对第
其中
与只取最后一个 GRU 状态不同,DIEN 保留全部
2.3 辅助损失
(1)用下一行为监督当前兴趣
如果
单个位置的辅助损失为:
批次损失只对同时存在当前行为和下一行为的位置计算:
其中
(2)负采样边界
负例不能等于对应位置的真实下一物品,也不应使用补零 ID。工程上可以采用重采样、采样后修正或受约束采样;若物品总数太少,必须显式处理不存在合法负例的情况。
辅助任务并不预测最终候选物品,它监督的是历史序列内部的相邻转移。训练时负例嵌入也通过同一物品嵌入表参与梯度更新;推理时不需要负例和辅助网络。
(3)联合目标
主任务损失为点击率二元交叉熵:
联合目标为:
2.4 候选物品相关的注意力
兴趣演化层先计算每个兴趣状态与候选物品的相关性。可采用双线性形式:
再在有效历史位置上归一化:
这里的注意力与 DIN 的未归一化激活不同。DIN 用加权和直接构造兴趣表示;DIEN 的
下文代码使用
2.5 三种注意力与 GRU 结合方式
(1)AIGRU
AIGRU 将注意力乘到输入上:
然后把
(2)AGRU
AGRU 直接用标量注意力替换向量更新门:
它使注意力直接控制更新强度,但同一个标量作用于所有隐藏维度,丢失了 GRU 更新门在不同维度上的选择能力。
(3)AUGRU
AUGRU 保留原始向量更新门
当某个兴趣状态与候选物品无关时,较小的
注意力分数决定相对更新强度,但不能直接解释为某个行为对最终点击的因果贡献。最终状态还依赖行为顺序、此前状态、候选向量和所有门控参数。
2.6 预测层
取兴趣演化层最后一个有效状态
下面的简化实现只保留用户 ID、候选物品和行为序列。空历史用户的最终兴趣为零,仍可依赖用户和候选物品特征完成预测。
2.7 与 DIN 的区别
| 对比项 | DIN | DIEN |
|---|---|---|
| 历史建模 | 候选相关的加权求和 | 两层循环网络建模兴趣状态与演化 |
| 时间顺序 | 不显式使用 | 按行为发生顺序递推 |
| 中间状态监督 | 无 | 下一行为辅助任务 |
| 候选物品作用位置 | 决定历史聚合权重 | 控制演化层逐步更新 |
| 推理额外输入 | 历史与候选物品 | 历史与候选物品;负例只用于训练 |
DIEN 的计算成本随历史长度线性增长,而且第二层状态依赖前一步,不能像普通加权池化那样完全并行。服务时需要结合历史截断、批量推理和候选数量评估延迟。
3. 模型实现
3.1 核心代码实现
下面给出可运行的 PyTorch 实现。为便于核对公式,循环按时间步展开,并用掩码保证补零位置不更新隐藏状态。
(1)兴趣提取与注意力
import torch
import torch.nn as nn
import torch.nn.functional as F
class InterestExtractor(nn.Module):
def __init__(self, dim):
super().__init__()
self.cell = nn.GRUCell(dim, dim)
def forward(self, sequence, mask):
batch_size, steps, dim = sequence.shape
state = sequence.new_zeros(batch_size, dim)
states = []
for t in range(steps):
candidate = self.cell(sequence[:, t], state)
valid = mask[:, t].unsqueeze(-1)
state = torch.where(valid, candidate, state)
states.append(state)
if not states:
return sequence.new_zeros(batch_size, 0, dim)
return torch.stack(states, dim=1)
class TargetAttention(nn.Module):
def __init__(self, dim):
super().__init__()
self.network = nn.Sequential(
nn.Linear(4 * dim, 80), nn.PReLU(),
nn.Linear(80, 40), nn.PReLU(), nn.Linear(40, 1),
)
def forward(self, states, target, mask):
if states.shape[1] == 0:
return states.new_zeros(mask.shape)
query = target[:, None, :].expand_as(states)
features = torch.cat(
[states, query, states - query, states * query], dim=-1
)
logits = self.network(features).squeeze(-1)
logits = logits.masked_fill(~mask, -torch.inf)
# Softmax 全为无效位置时会产生 NaN,因此只处理非空历史。
weights = torch.zeros_like(logits)
nonempty = mask.any(dim=1)
weights[nonempty] = torch.softmax(logits[nonempty], dim=1)
return weights
(2)AUGRU 兴趣演化
class AUGRUCell(nn.Module):
def __init__(self, dim):
super().__init__()
self.input_linear = nn.Linear(dim, 3 * dim)
self.hidden_linear = nn.Linear(dim, 3 * dim)
def forward(self, x, state, attention):
input_reset, input_update, input_new = self.input_linear(x).chunk(3, -1)
hidden_reset, hidden_update, hidden_new = self.hidden_linear(state).chunk(3, -1)
reset = torch.sigmoid(input_reset + hidden_reset)
update = torch.sigmoid(input_update + hidden_update)
candidate = torch.tanh(input_new + reset * hidden_new)
attentive_update = attention.unsqueeze(-1) * update
return (1 - attentive_update) * state + attentive_update * candidate
class InterestEvolution(nn.Module):
def __init__(self, dim):
super().__init__()
self.cell = AUGRUCell(dim)
def forward(self, states, attention, mask):
batch_size, steps, dim = states.shape
evolved = states.new_zeros(batch_size, dim)
for t in range(steps):
candidate = self.cell(states[:, t], evolved, attention[:, t])
evolved = torch.where(mask[:, t, None], candidate, evolved)
return evolved
当 attention=0 时,AUGRU 的注意力更新门为零,输出严格等于上一状态。这正是它与 AIGRU 的关键差别。
(3)辅助任务与完整模型
class AuxiliaryNetwork(nn.Module):
def __init__(self, dim):
super().__init__()
self.network = nn.Sequential(
nn.Linear(2 * dim, 64), nn.PReLU(), nn.Linear(64, 1)
)
def forward(self, states, items):
return self.network(torch.cat([states, items], dim=-1)).squeeze(-1)
class DIEN(nn.Module):
def __init__(self, num_users, num_items, dim=16):
super().__init__()
self.num_items = num_items
self.user_embedding = nn.Embedding(num_users, dim)
# 0 专用于补零,真实物品 ID 为 1..num_items。
self.item_embedding = nn.Embedding(num_items + 1, dim, padding_idx=0)
self.extractor = InterestExtractor(dim)
self.attention = TargetAttention(dim)
self.evolution = InterestEvolution(dim)
self.auxiliary = AuxiliaryNetwork(dim)
self.predictor = nn.Sequential(
nn.Linear(3 * dim, 128), nn.PReLU(),
nn.Linear(128, 64), nn.PReLU(), nn.Linear(64, 1),
)
def forward(self, users, targets, history, lengths, negative_history=None):
if history.ndim != 2 or lengths.shape != (history.shape[0],):
raise ValueError("history 应为 [B, T],lengths 应为 [B]")
if torch.any(lengths < 0) or torch.any(lengths > history.shape[1]):
raise ValueError("历史长度超出有效范围")
steps = history.shape[1]
mask = torch.arange(steps, device=history.device)[None, :] < lengths[:, None]
history = history.masked_fill(~mask, 0)
sequence = self.item_embedding(history)
target = self.item_embedding(targets)
states = self.extractor(sequence, mask)
weights = self.attention(states, target, mask)
interest = self.evolution(states, weights, mask)
features = torch.cat([self.user_embedding(users), target, interest], dim=-1)
logits = self.predictor(features).squeeze(-1)
auxiliary_loss = logits.new_zeros(())
if negative_history is not None and steps > 1:
if negative_history.shape != history.shape:
raise ValueError("negative_history 必须与 history 形状相同")
next_mask = mask[:, 1:]
positive = sequence[:, 1:]
negatives = self.item_embedding(negative_history[:, 1:])
positive_logits = self.auxiliary(states[:, :-1], positive)
negative_logits = self.auxiliary(states[:, :-1], negatives)
if next_mask.any():
positive_loss = F.binary_cross_entropy_with_logits(
positive_logits[next_mask], torch.ones_like(positive_logits[next_mask])
)
negative_loss = F.binary_cross_entropy_with_logits(
negative_logits[next_mask], torch.zeros_like(negative_logits[next_mask])
)
auxiliary_loss = positive_loss + negative_loss
return logits, auxiliary_loss
传入的 negative_history[:, t] 对应 history[:, t] 的负例;位置 0 不参与辅助任务。数据管道必须保证每个有效负例既不是 0,也不等于同位置正例。
(4)前向预测与训练示例
torch.manual_seed(42)
model = DIEN(num_users=10, num_items=100, dim=8)
users = torch.tensor([0, 1, 2, 3])
targets = torch.tensor([8, 15, 30, 9])
history = torch.tensor([
[1, 2, 3, 4],
[10, 11, 12, 0],
[20, 0, 0, 0],
[0, 0, 0, 0],
])
lengths = torch.tensor([4, 3, 1, 0])
negative_history = torch.tensor([
[41, 42, 43, 44],
[50, 51, 52, 0],
[60, 0, 0, 0],
[0, 0, 0, 0],
])
labels = torch.tensor([1., 0., 1., 0.])
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
model.train()
logits, auxiliary_loss = model(
users, targets, history, lengths, negative_history
)
target_loss = nn.BCEWithLogitsLoss()(logits, labels)
loss = target_loss + 0.1 * auxiliary_loss
optimizer.zero_grad()
loss.backward()
optimizer.step()
model.eval()
with torch.no_grad():
logits, _ = model(users, targets, history, lengths)
probabilities = torch.sigmoid(logits)
print("Prediction shape:", probabilities.shape)
print("Training loss:", loss.item())
3.2 实验与工程注意事项
- 先验证序列口径:明确行为类型、排序时间、重复行为和截断规则,保证线上与离线使用同一套历史构造逻辑。
- 分别做模块消融:比较普通 GRU、加入辅助损失、AIGRU、AGRU 与 AUGRU,判断收益来自逐步监督还是候选相关演化。
- 监控两项损失:同时记录主任务和辅助任务损失。
- 审计负采样:避免采到真实下一物品、补零 ID 或不符合时间约束的物品,并记录采样分布随时间的变化。
- 验证掩码边界:测试空历史、长度 1、满长度和额外补零,确保预测及有效位置的梯度不受补齐长度影响。
- 控制服务成本:不同候选物品会产生不同注意力和演化过程。候选量较大时,应测量真实批量、历史长度下的延迟与显存。
4. 总结
DIEN 将用户行为序列建模拆成兴趣提取和兴趣演化两个阶段。第一层 GRU 生成逐时刻兴趣状态,辅助损失用真实下一行为与负样本为中间状态提供监督;第二层 AUGRU 用候选物品相关注意力缩放更新门,追踪与当前目标相关的兴趣演化。
理解 DIEN 的关键是区分三个信号:行为序列提供时间依赖,辅助任务约束中间兴趣状态,候选物品注意力决定哪些状态应推动最终兴趣更新。这也为后续会话兴趣和长序列兴趣模型建立了基础。
5. 参考文献
[1] Zhou G, Mou N, Fan Y, et al. Deep Interest Evolution Network for Click-Through Rate Prediction. AAAI, 2019.
[2] Zhou G, Song C, Zhu X, et al. Deep Interest Network for Click-Through Rate Prediction. KDD, 2018.
[3] Chung J, Gulcehre C, Cho K, Bengio Y. Empirical Evaluation of Gated Recurrent Neural Networks on Sequence Modeling. NIPS Workshop, 2014.
[4] Xiong C, Merity S, Socher R. Dynamic Memory Networks for Visual and Textual Question Answering. ICML, 2016.