SIM:基于搜索的终身序列兴趣建模
总阅读量 加载中... 次
SIM(Search-based Interest Model)发表于 CIKM 2020,论文题为 Search-based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction [1]。
SIM 面向点击率预估中的超长用户行为序列。它不把上万条行为直接送入复杂网络,而是先用通用搜索单元从终身行为中找出与候选物品相关的少量行为,再由精确搜索单元建模候选物品与这些行为的细粒度关系。这种“先检索、再建模”的两阶段结构同时控制了噪声、存储访问量和在线延迟。
1. 背景
DIN、DIEN 等模型通常只使用最近几十或几百条行为。截断虽然便于服务,却会丢失很久以前仍然有效的兴趣;直接将终身行为扩展到上万条,又会使注意力计算、特征传输和在线推理成本随序列长度增长。
另一个问题是噪声。给一件运动鞋预估点击率时,用户多年前浏览过的运动装备可能仍有价值,而最近浏览的厨房用品未必相关。仅按时间截取无法保证行为与当前候选相关。
设用户终身行为序列为:
候选物品为
2. 模型架构
2.1 整体结构
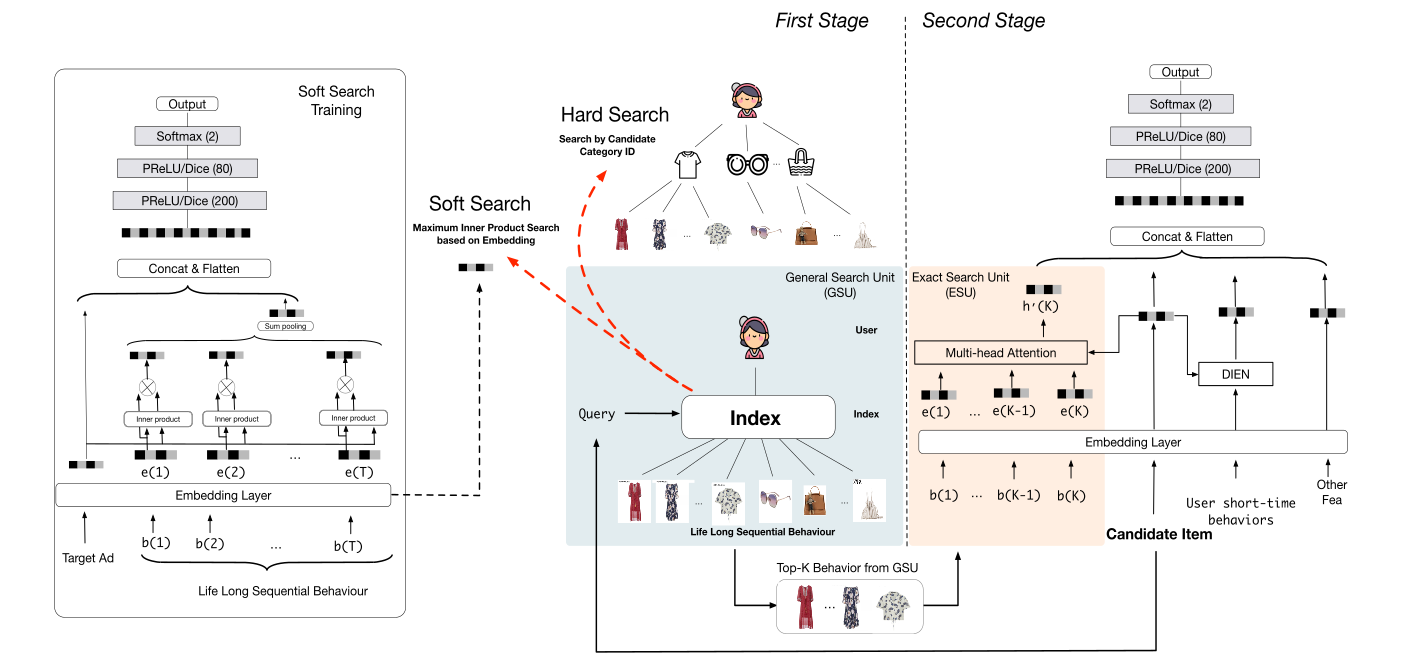
SIM架构图
SIM 由两个阶段组成:
- 通用搜索单元:以候选物品为查询,从终身行为中检索 Top-
- 精确搜索单元:把检索到的行为和时间间隔共同编码,通过多头注意力提取多样的长期兴趣。
精确长期兴趣、候选物品、短期行为兴趣和其他特征最终拼接后送入多层感知机,输出点击概率。软搜索还带有一条辅助点击率预估路径,用终身行为数据训练检索向量。
2.2 通用搜索单元
2.2.1 统一检索形式
通用搜索单元为行为
其中
通用搜索只负责快速缩小范围。它可以牺牲一部分精细表达能力,但必须具备足够高的相关行为召回率,并满足在线延迟和索引更新要求。
2.2.2 硬搜索
硬搜索保留与候选物品类别相同的历史行为:
它没有可训练参数,可按类别为每个用户维护倒排行为索引。请求到达时,以候选类别为键直接读取对应行为链,并截取最近
类别粒度决定召回范围。粒度太粗会引入大量噪声,太细会漏掉跨类别相关行为。实际系统可以采用多级类目、业务标签或类目映射,并对各索引桶设置独立容量。
2.2.3 软搜索
软搜索先将行为和候选映射到检索空间,再以内积计算相关性:
当终身序列很长时,不应在线逐条计算内积,而应把用户行为向量写入最大内积搜索索引,通过近似检索得到 Top-
短期行为与长期行为的数据分布不同,不能直接拿短期兴趣网络中的嵌入充当长期检索向量。SIM 使用基于长期行为的辅助点击率任务训练软搜索。行为表示为:
将
2.3 精确搜索单元
通用搜索得到
将行为嵌入
第
多个头的结果拼接为长期兴趣:
不同注意力头拥有独立投影,可以从品牌、类目、价格区间或时间距离等不同角度关注行为。时间间隔参与行为表示,使同一物品在一天前和一年以前发生时获得不同权重。
2.4 预测层与训练目标
长期兴趣
经多层感知机输出点击概率:
精确搜索路径使用二元交叉熵
软搜索可令两条损失都参与训练;硬搜索没有可学习参数,因此令
2.5 在线服务
硬搜索适合使用用户行为树或等价的分桶索引。每个用户的终身行为按类目组织,叶子节点保存该类目下的行为及其时间。候选物品到达后,通过候选类目直接定位行为桶,读取最近
软搜索则需要为每个用户的行为向量维护最大内积索引。若模型更新了
无论使用哪种搜索,都应记录以下指标:
- GSU 的检索耗时、有效返回数量和相关行为覆盖率;
- ESU 的序列长度分布、注意力熵和推理耗时;
- 不同历史长度用户的 AUC、点击率和空结果率;
- 索引延迟、版本一致性及新行为写入延迟。
3. 模型实现
3.1 核心代码实现
下面给出可运行的 PyTorch 实现。输入序列按时间从旧到新排列,物品 ID 和类别 ID 的 0 值专用于补零。实现同时支持硬搜索和软搜索;硬搜索在同类行为中保留最近
import torch
import torch.nn as nn
import torch.nn.functional as F
def masked_softmax(scores, mask, dim=-1):
masked_scores = scores.masked_fill(~mask, -1e9)
weights = torch.softmax(masked_scores, dim=dim)
weights = weights * mask.to(weights.dtype)
return weights / weights.sum(dim=dim, keepdim=True).clamp_min(1e-12)
class GeneralSearchUnit(nn.Module):
def __init__(self, item_dim, search_dim, top_k, mode="hard"):
super().__init__()
if mode not in {"hard", "soft"}:
raise ValueError("mode must be 'hard' or 'soft'")
self.top_k = top_k
self.mode = mode
self.behavior_proj = nn.Linear(item_dim, search_dim, bias=False)
self.target_proj = nn.Linear(item_dim, search_dim, bias=False)
def forward(self, behavior_emb, target_emb, behavior_category,
target_category, padding_mask):
batch_size, length, _ = behavior_emb.shape
k = min(self.top_k, length)
if self.mode == "hard":
related = behavior_category.eq(target_category.unsqueeze(1))
valid = padding_mask & related
# 同类行为分数按位置递增,Top-K 因而保留最近的行为。
positions = torch.arange(
length, device=behavior_emb.device, dtype=behavior_emb.dtype
)
scores = positions.unsqueeze(0).expand(batch_size, -1)
else:
valid = padding_mask
behavior_key = self.behavior_proj(behavior_emb)
target_query = self.target_proj(target_emb).unsqueeze(1)
scores = (behavior_key * target_query).sum(dim=-1)
scores = scores.masked_fill(~valid, -1e9)
top_scores, top_indices = scores.topk(k, dim=1)
selected_mask = top_scores.gt(-1e8)
gather_index = top_indices.unsqueeze(-1).expand(-1, -1, behavior_emb.size(-1))
selected_emb = behavior_emb.gather(1, gather_index)
selected_emb = selected_emb * selected_mask.unsqueeze(-1)
return selected_emb, top_indices, selected_mask, scores
class ExactSearchUnit(nn.Module):
def __init__(self, item_dim, time_dim, attention_dim, num_heads):
super().__init__()
self.num_heads = num_heads
behavior_dim = item_dim + time_dim
self.behavior_proj = nn.ModuleList([
nn.Linear(behavior_dim, attention_dim, bias=False)
for _ in range(num_heads)
])
self.target_proj = nn.ModuleList([
nn.Linear(item_dim, attention_dim, bias=False)
for _ in range(num_heads)
])
def forward(self, selected_emb, time_emb, target_emb, selected_mask):
behavior = torch.cat([selected_emb, time_emb], dim=-1)
heads = []
attention_weights = []
for behavior_proj, target_proj in zip(
self.behavior_proj, self.target_proj
):
keys = behavior_proj(behavior)
query = target_proj(target_emb).unsqueeze(1)
scores = (keys * query).sum(dim=-1)
weights = masked_softmax(scores, selected_mask, dim=1)
heads.append((weights.unsqueeze(-1) * behavior).sum(dim=1))
attention_weights.append(weights)
return torch.cat(heads, dim=-1), torch.stack(attention_weights, dim=1)
class SIM(nn.Module):
def __init__(self, num_items, num_time_buckets, item_dim=32,
time_dim=8, attention_dim=32, num_heads=4,
top_k=50, search_mode="hard"):
super().__init__()
self.item_embedding = nn.Embedding(
num_items + 1, item_dim, padding_idx=0
)
self.time_embedding = nn.Embedding(
num_time_buckets, time_dim
)
self.gsu = GeneralSearchUnit(
item_dim, item_dim, top_k, mode=search_mode
)
self.esu = ExactSearchUnit(
item_dim, time_dim, attention_dim, num_heads
)
input_dim = num_heads * (item_dim + time_dim) + 2 * item_dim
self.predictor = nn.Sequential(
nn.Linear(input_dim, 128),
nn.PReLU(),
nn.Linear(128, 64),
nn.PReLU(),
nn.Linear(64, 1),
)
def forward(self, behavior_ids, behavior_categories, target_id,
target_category, time_bucket, short_behavior_ids):
padding_mask = behavior_ids.ne(0)
behavior_emb = self.item_embedding(behavior_ids)
target_emb = self.item_embedding(target_id)
selected_emb, indices, selected_mask, search_scores = self.gsu(
behavior_emb, target_emb, behavior_categories,
target_category, padding_mask
)
selected_time = time_bucket.gather(1, indices)
selected_time = selected_time.masked_fill(~selected_mask, 0)
time_emb = self.time_embedding(selected_time)
time_emb = time_emb * selected_mask.unsqueeze(-1)
long_interest, attention = self.esu(
selected_emb, time_emb, target_emb, selected_mask
)
short_mask = short_behavior_ids.ne(0)
short_emb = self.item_embedding(short_behavior_ids)
short_sum = (short_emb * short_mask.unsqueeze(-1)).sum(dim=1)
short_interest = short_sum / short_mask.sum(
dim=1, keepdim=True
).clamp_min(1)
features = torch.cat(
[long_interest, short_interest, target_emb], dim=-1
)
logits = self.predictor(features).squeeze(-1)
return logits, search_scores, attention, selected_mask
3.2 训练示例
硬搜索只需优化主预测损失:
model = SIM(
num_items=100_000,
num_time_buckets=32,
top_k=50,
search_mode="hard",
)
logits, search_scores, attention, selected_mask = model(
behavior_ids=behavior_ids,
behavior_categories=behavior_categories,
target_id=target_id,
target_category=target_category,
time_bucket=time_bucket,
short_behavior_ids=short_behavior_ids,
)
loss = F.binary_cross_entropy_with_logits(logits, labels.float())
loss.backward()
软搜索模式下,search_scores 是候选物品与全部有效行为的检索分数。工程训练应根据长期行为样本构造独立的 GSU 点击率头,计算
3.3 实现要点
- 补零掩码贯穿两阶段:补零行为既不能进入 Top-
- 空检索结果返回零兴趣:
masked_softmax在所有位置无效时输出全零,而不是均匀分布或NaN。 - 时间桶要按业务尺度设计:可使用分钟、小时、天的分段桶;长尾区间通常采用对数式边界。
- 保持序列语义一致:示例假设位置越大越新。若数据顺序相反,硬搜索的最近行为选择也必须反转。
- 避免泄漏未来行为:终身序列只能包含样本曝光时间以前发生的事件,时间间隔也必须相对该曝光时间计算。
- 训练与服务共享检索规则:类目映射、向量版本、Top-
3.4 复杂度分析
若直接对长度
其中
内存成本仍然不会消失:系统需要保存终身行为或行为向量索引。SIM 主要减少请求时传输和参与复杂计算的数据量,因此还需要配合行为过期策略、分层存储和索引压缩。
4. 总结
SIM 用两阶段搜索解决终身行为序列的兴趣建模问题。GSU 先在上万条历史中检索与候选物品相关的少量行为,ESU 再融合行为内容与时间间隔,通过多头注意力提取精确的长期兴趣。硬搜索依赖类目索引,结构简单且易于低延迟服务;软搜索使用可学习内积,能够覆盖跨类别关系,但需要辅助任务和严格的索引版本管理。
这一结构的核心价值是把昂贵模型的输入规模从
5. 参考文献
[1] Pi Q, Bian W, Zhou G, Zhu X, Gai K. Search-based User Interest Modeling with Lifelong Sequential Behavior Data for Click-Through Rate Prediction. CIKM, 2020.
[2] Zhou G, Zhu X, Song C, et al. Deep Interest Network for Click-Through Rate Prediction. KDD, 2018.
[3] Zhou G, Mou N, Fan Y, et al. Deep Interest Evolution Network for Click-Through Rate Prediction. AAAI, 2019.