DCN V2:矩阵交叉与低秩混合专家
总阅读量 加载中... 次
DCN V2(Deep & Cross Network V2)是 Google 提出的特征交叉模型,发表于 WWW 2021,论文题为 DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-scale Learning to Rank Systems [1]。
DCN V2 的核心思想是将 DCN 的向量式交叉扩展为矩阵式交叉,让不同输出维度学习不同的交互组合;同时通过低秩分解和混合专家控制计算成本,并与深度网络结合,用于点击率预估等精排任务。
1. 背景
在精排模型中,单独的特征往往不足以解释用户行为。例如,“用户所在地区”和“内容语言”分别提供一部分信息,而两者的组合更直接影响用户是否点击。交叉网络的目标是从输入中学习这类组合关系,减少对人工交叉特征的依赖。
DCN 通过下面的递推构造交叉:
其中
DCN V2 为每个输出维度提供独立的交互权重,使交叉层从“一次标量聚合”变为“多个维度分别聚合”。随后再用低秩结构压缩矩阵,并利用多个子空间分担交互建模。
2. 模型架构
2.1 整体网络结构
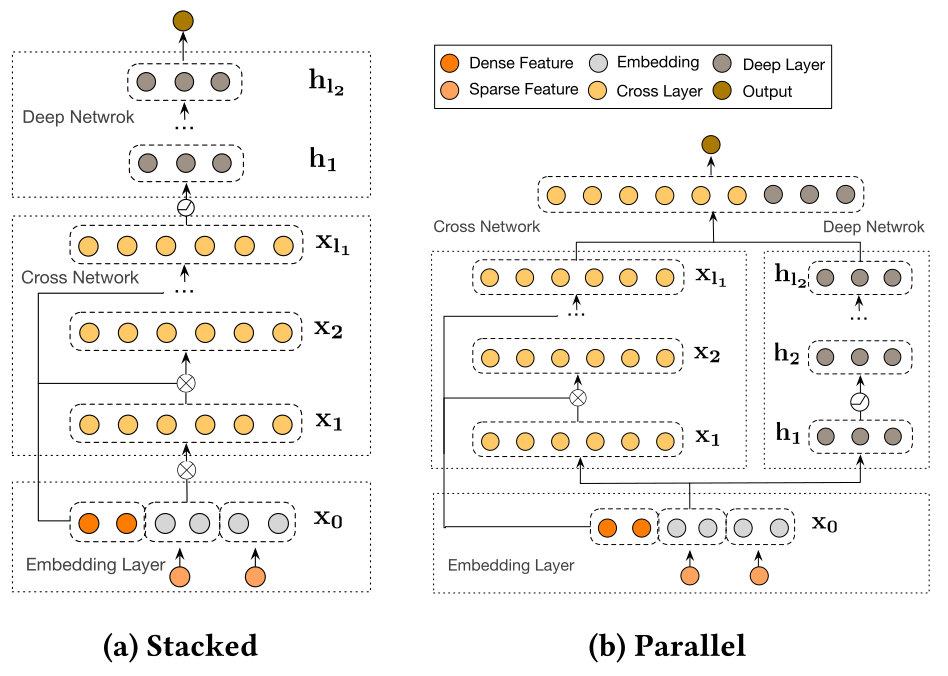
DCN V2架构图
DCN V2 包含输入层、交叉网络、深度网络和预测层,图中给出了两种组合方式:
- 串行结构:输入先经过交叉网络,再进入深度网络,最后得到预测结果。
- 并行结构:交叉网络与深度网络分别处理同一份输入,拼接两路输出后进行预测。
两种结构使用相同的交叉层定义,区别在于深度网络接收什么输入,以及预测层如何融合表示。低秩分解与混合专家可以作为交叉层的内部实现,分别用于这两种结构。
2.2 输入层
对类别特征进行嵌入编码,对多值类别特征进行池化,再与经过处理的数值特征拼接:
如果第
不同字段的嵌入维度不必相同,因为交叉网络处理的是拼接后的向量。例如,高基数字段可以分配较大的嵌入维度,低基数字段可以使用较小的维度。
这里的显式交叉发生在嵌入坐标及数值特征之间,不等同于直接枚举类别 ID 的所有组合。数值特征的尺度会影响乘性交互,应在输入阶段处理缺失值、异常值与归一化问题。
2.3 矩阵交叉网络
(1)交叉层公式
DCN V2 的第
其中
- 通过
- 与初始输入
- 加上
每一层都与同一个
(2)为什么矩阵比向量更灵活
第
不同输出维度使用
两个输出维度可以独立调整对应的交叉系数。相比之下,向量式交叉的各行权重受到共享约束。
令
因此,矩阵式交叉包含向量式的乘性交互部分作为特殊情况。若要将两种完整层公式逐项对应,还需要处理偏置的位置差异;在零偏置条件下,两者可以直接对应,不能仅替换
(3)交叉次数与参数量
对于不包含非线性激活和输入相关门控的基础交叉网络,
这一结论描述的是可形成的交互次数,不代表所有高阶项都拥有完全独立的参数,也不保证所有高阶项都会在训练后保留非零系数。
全矩阵交叉层的参数量为:
单样本计算复杂度为
2.4 低秩分解
当交叉矩阵的主要信息可以由较少的方向表达时,可以直接将权重参数化为两个低秩因子的乘积:
其中
计算顺序为:
先降维,再升维。实现时无需显式构造
每层参数量为
这里的低秩结构可以从训练开始就与其他模块联合优化,并不要求先训练全矩阵,再通过奇异值分解压缩。它是一种容量约束,因此
2.5 低秩混合专家
(1)多个交互子空间
单个低秩矩阵只能在有限的子空间中建模。设一层包含
使用门控网络根据当前表示计算专家权重。本文采用 Softmax 门控:
其中
所有专家都参与计算,这是稠密门控,不是只激活少数专家的稀疏路由。增加专家数量同样会增加计算成本。
(2)在低维空间引入非线性
进一步引入
下文代码使用
(3)与多任务专家的区别
MMoE 主要为不同任务学习专家组合;这里的专家位于交叉层内部,负责学习不同交互子空间。即使只有一个 CTR 预测任务,也可以使用低秩混合专家。
基础矩阵交叉网络的
(4)计算成本对比
下表只统计一层交叉模块;混合专家使用共享偏置和无偏置线性门控,不包含嵌入层、深度网络及预测层。
| 交叉层 | 参数量 | 单样本计算复杂度 |
|---|---|---|
| 全矩阵 |
|
|
| 单个低秩交叉 |
|
|
| 线性低秩混合专家 |
|
|
| 非线性低秩混合专家 |
|
|
例如,
2.6 深度网络与预测层
深度网络可以由多层全连接层和 ReLU 构成:
在串行结构中:
在并行结构中:
最后使用线性预测层:
串行结构使深度网络直接处理已交叉的特征;并行结构让深度分支保留独立处理输入的路径。哪一种更合适取决于数据和资源预算,应在相同输入、训练与评估条件下比较。
2.7 损失函数
对于点击率预估,使用二元交叉熵:
还可以对选定权重加入 L2 正则化:
交叉网络本身不限定预测任务。更换输出层和训练目标后,也可用于其他排序任务。下面代码直接输出 Logits,并使用数值稳定的 BCEWithLogitsLoss。
3. 模型实现
3.1 核心代码实现
下面使用 PyTorch 实现全矩阵、低秩和非线性低秩混合专家三种交叉层,并支持串行与并行结构。输入 x 已完成类别特征编码、池化和数值特征拼接,形状为 [B, D]。
(1)全矩阵与低秩交叉层
import torch
import torch.nn as nn
class CrossLayer(nn.Module):
def __init__(self, dim, rank=None):
super().__init__()
if rank is None:
self.projection = nn.Linear(dim, dim, bias=False)
else:
if not 1 <= rank <= dim:
raise ValueError("rank 必须在 1 到 dim 之间")
self.projection = nn.Sequential(
nn.Linear(dim, rank, bias=False),
nn.Linear(rank, dim, bias=False),
)
self.bias = nn.Parameter(torch.zeros(dim))
def forward(self, x0, xl):
# 偏置在逐元素乘法内部,每层始终与初始输入 x0 交叉。
return xl + x0 * (self.projection(xl) + self.bias)
PyTorch 的线性层对行向量执行 x @ weight.T,因此全矩阵模式中的 projection.weight 对应公式里的
(2)低秩混合专家交叉层
class CrossMixLayer(nn.Module):
def __init__(self, dim, rank=16, num_experts=4):
super().__init__()
if not 1 <= rank <= dim or num_experts < 1:
raise ValueError("rank 或专家数量无效")
self.experts = nn.ModuleList([
nn.Sequential(
nn.Linear(dim, rank, bias=False),
nn.Tanh(),
nn.Linear(rank, rank, bias=False),
nn.Tanh(),
nn.Linear(rank, dim, bias=False),
)
for _ in range(num_experts)
])
self.gate = nn.Linear(dim, num_experts, bias=False)
self.bias = nn.Parameter(torch.zeros(dim))
def forward(self, x0, xl):
weights = torch.softmax(self.gate(xl), dim=-1) # [B, K]
outputs = torch.stack(
[expert(xl) for expert in self.experts], dim=1
) # [B, K, D]
mixed = (outputs * weights.unsqueeze(-1)).sum(dim=1)
return xl + x0 * (mixed + self.bias)
由于各专家共用
(3)完整模型
class DCNV2(nn.Module):
def __init__(self, input_dim, num_cross_layers=3,
deep_dims=(128, 64), structure="parallel",
cross_type="matrix", rank=16, num_experts=4):
super().__init__()
if structure not in ("stacked", "parallel"):
raise ValueError("structure 必须是 stacked 或 parallel")
if cross_type not in ("matrix", "low_rank", "mix"):
raise ValueError("cross_type 必须是 matrix、low_rank 或 mix")
if input_dim < 1 or num_cross_layers < 1:
raise ValueError("输入维度和交叉层数必须为正整数")
if not deep_dims or any(width < 1 for width in deep_dims):
raise ValueError("深度网络至少需要一层,且层宽必须为正整数")
self.structure = structure
layers = []
for _ in range(num_cross_layers):
if cross_type == "mix":
layer = CrossMixLayer(input_dim, rank, num_experts)
else:
layer = CrossLayer(
input_dim, rank if cross_type == "low_rank" else None
)
layers.append(layer)
self.cross_layers = nn.ModuleList(layers)
deep_layers = []
width = input_dim
for next_width in deep_dims:
deep_layers.extend([nn.Linear(width, next_width), nn.ReLU()])
width = next_width
self.deep = nn.Sequential(*deep_layers)
output_dim = width + input_dim if structure == "parallel" else width
self.head = nn.Linear(output_dim, 1)
def forward(self, x):
x0, xl = x, x
for layer in self.cross_layers:
xl = layer(x0, xl)
if self.structure == "stacked":
combined = self.deep(xl)
else:
combined = torch.cat([xl, self.deep(x0)], dim=-1)
return self.head(combined).squeeze(-1)
cross_type="matrix" 对应基础 DCN V2,"low_rank" 对应单个低秩交叉,"mix" 对应带非线性变换的低秩混合专家。参数 structure 独立控制串行或并行组合。
(4)前向预测与训练示例
torch.manual_seed(42)
model = DCNV2(
input_dim=64,
num_cross_layers=3,
deep_dims=(128, 64),
structure="parallel",
cross_type="mix",
rank=8,
num_experts=4,
)
x = torch.randn(16, 64)
labels = torch.randint(0, 2, (16,)).float()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
criterion = nn.BCEWithLogitsLoss()
model.train()
logits = model(x)
loss = criterion(logits, labels)
optimizer.zero_grad()
loss.backward()
optimizer.step()
model.eval()
with torch.no_grad():
probabilities = torch.sigmoid(model(x))
print("Prediction shape:", probabilities.shape)
print("Training loss:", loss.item())
模拟数据仅用于检查计算流程,不代表真实点击率效果。示例没有加入额外的 L2 项,也没有实现数据采样、训练集划分或在线服务。
3.2 实验与工程注意事项
- 先比较简单基线:固定嵌入编码、数据划分与训练预算,对比深度网络、全矩阵交叉和低秩交叉,再评估混合专家是否带来足够收益。
- 联合调整秩与专家数量:只减小单个专家的秩,但大幅增加专家数量,未必能减少总成本;应同时记录参数量、吞吐、内存和推理延迟。
- 控制乘性交互的尺度:检查输入归一化、权重初始化及梯度情况。增加交叉层数不保证效果持续提升,交互次数与训练稳定性需要一起考虑。
- 区分训练指标与业务收益:AUC、LogLoss 适合离线评估,但不能代替线上点击、转化与延迟指标。不同论文中的提升比例不能直接移植到自己的业务。
- 谨慎解释交叉权重:可以按字段切分
4. 总结
DCN V2 在 DCN 的基础上放宽了交叉层的参数约束,让不同输出维度分别学习交互组合。全矩阵提高表达能力,低秩分解降低投影成本,混合专家进一步利用多个交互子空间,构成了一组可按资源预算选择的交叉模块。
理解这个模型需要区分三个层面:交叉层内部如何计算、交叉网络如何与深度网络组合,以及训练目标如何定义。其中,矩阵交叉与低秩线性交叉具有明确的多项式次数边界;非线性混合专家增强了灵活性,但不再直接满足相同的有限次多项式描述。
5. 参考文献
[1] Wang R, Shivanna R, Cheng D, et al. DCN V2: Improved Deep & Cross Network and Practical Lessons for Web-scale Learning to Rank Systems. WWW, 2021.
[2] Wang R, Fu B, Fu G, Wang M. Deep & Cross Network for Ad Click Predictions. AdKDD, 2017.
[3] Jacobs R A, Jordan M I, Nowlan S J, Hinton G E. Adaptive Mixtures of Local Experts. Neural Computation, 1991.
[4] Ma J, Zhao Z, Yi X, et al. Modeling Task Relationships in Multi-task Learning with Multi-gate Mixture-of-Experts. KDD, 2018.