Transformer:编码器与解码器的结构与计算
总阅读量 加载中... 次
Transformer 通过注意力、逐位置前馈网络与位置编码构建序列到序列模型,在不依赖循环状态逐步传递的情况下学习序列内部及序列之间的关系。经典编码器—解码器结构发表于 2017 年的 Attention Is All You Need [1]。
完整 Transformer 由输入表示、注意力交互、逐位置前馈网络、残差与归一化以及词表输出构成。模块排列、张量形状、词元对齐和训练生成流程共同决定网络行为。编码器、解码器和仅解码器模型承担不同任务,不能混为同一种输入输出配置。
1. 背景
循环模型按时间顺序更新隐藏状态,远距离依赖需要经过多个状态传递。Transformer 在一个注意力层内让允许交互的位置直接交换信息,同时可在训练时并行处理多个序列位置。
注意力并不自动理解先后顺序,因此需要额外的位置信息。解码器也不能在预测下一个词元时读取未来答案,需要通过因果约束屏蔽不合法的信息路径。
序列到序列任务估计条件概率:
编码器处理源序列
2. 模型架构
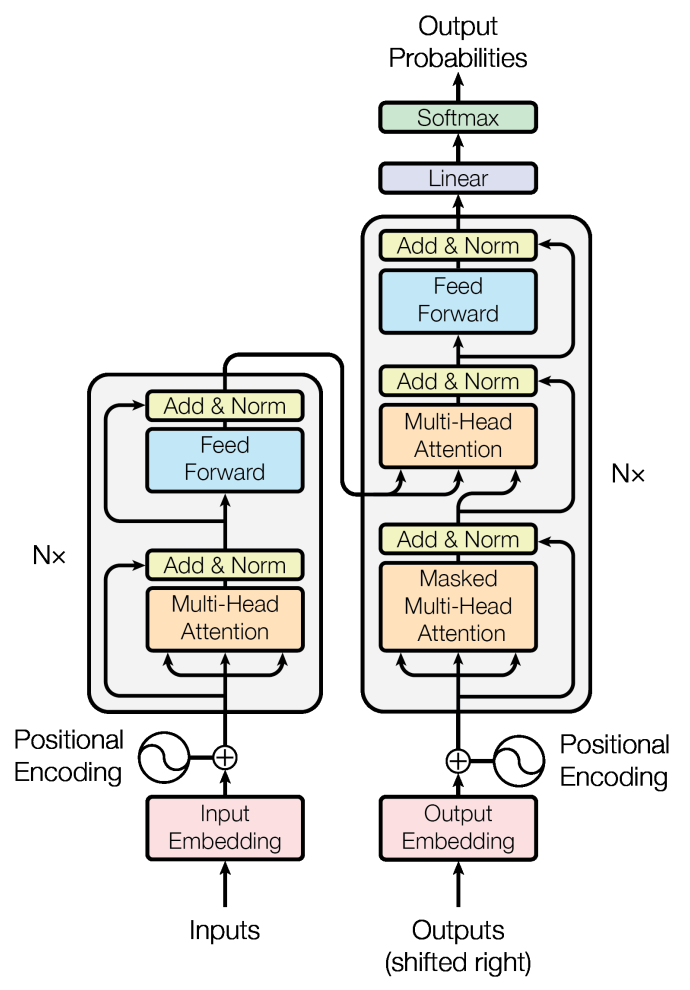
Transformer架构图
编码器由多层双向自注意力与前馈网络组成,输出源序列表示。解码器每层包含带掩码自注意力、编码器—解码器交叉注意力和前馈网络,最后经线性投影得到目标词表得分。
经典基础配置中,编码器和解码器各堆叠 6 层,隐藏维度为 512,注意力头数为 8,前馈中间宽度为 2048。这些是具体配置,不是 Transformer 的必要定义;运行示例使用更小的网络。
2.1 编码器与解码器堆叠
2.1.1 编码器
经典后置归一化结构为:
自注意力的查询、键和值来自同一个源表示。忽略补零位置后,每个源位置可以读取源序列其他有效位置,不使用目标侧因果约束。
前馈网络逐位置共享参数:
它在隐藏维度上变换表示,不直接混合不同位置。注意力交换位置信息,前馈层执行非线性特征变换,两者共同构成编码器块。
Transformer编码器架构图
编码器每层的输入输出都为
“堆叠相同结构”通常表示每层具有相同模块配置,不意味着层间共享同一组参数。示例逐层创建独立模块,允许各层学习不同变换。
2.1.2 解码器
设解码器输入为
第一步只允许目标前缀内部合法交互,第二步由目标位置发起查询,读取源表示的键和值。交叉注意力得分形状为
现代网络也常使用前置归一化,结构和梯度路径均有变化。示例明确使用后置形式,不将两种布局视为可随意互换的实现细节。
Transformer解码器架构图
交叉注意力中,编码器记忆不会被当前目标查询原地改写。每层解码器可以使用自己的键和值投影,因此即使读取同一份记忆,也能建立不同的源目标关系。整个解码器层保持
源上下文对于当前条件生成任务是已知信息,因此交叉注意力一般不使用目标侧的上三角因果掩码。将目标因果矩阵直接套到交叉注意力,既可能形状不符,也可能无理由屏蔽源位置。
2.1.3 残差连接与层归一化
Transformer残差归一化架构图
残差分支保留输入路径,子层提供增量。对于后置形式,先得到
不同样本、不同词元各自计算统计量,不能沿整个序列或批次求一个共同均值。缩放和平移参数在位置间共享,形状均为
残差相加不会把张量宽度翻倍,拼接才会改变对应维度。训练时随机失活放在子层输出路径,恒等残差路径仍存在;后置归一化则继续作用于相加结果,不能声称梯度完全绕过归一化。
前向时,层归一化的均值与方差均从当前词元计算;训练和推理使用相同统计范围,不维护跨批次运行均值。可学习的
反向时,每个词元的所有通道通过均值与方差相互依赖。若
均值均沿当前词元的通道轴计算。残差相加再把这份梯度分别传到恒等输入路径和子层输出路径,两条路径对共享输入的贡献相加。随机失活沿前向保存的同一掩码反传,不能在反向重新抽样。
这些机制改善表示与优化的条件,但不消除错误掩码、过大学习率或数值异常。检查时需要同时核对统计轴、残差形状、随机失活模式与梯度是否有限。
2.2 注意力
2.2.1 缩放点积注意力
查询表示当前位置需要检索什么,键表示上下文各位置用于匹配的特征,值表示被检索后实际传递的内容。三者由可学习投影生成,同一输入可以同时承担查询、键和值的来源,但不意味着投影矩阵必须相同。
设单头查询
沿键位置归一化,再加权求和:
输出长度由查询长度
Transformer缩放点积注意力架构图
对某个查询位置,得分行中的
2.2.2 多头注意力
对查询输入
将每个投影拆为
Transformer多头注意力架构图
多个头通过不同投影读取不同表示子空间。它们可以关注不同关系,但不保证每个头天然对应某种人工语义。头输出在特征维拼接,查询位置维不发生拼接,因此输出仍包含
若
2.2.3 注意力在模型中的应用
目标因果掩码为:
主对角线可以读取,因为目标输入已经右移。源补零掩码用于编码器自注意力与解码器交叉注意力,目标补零掩码用于目标自注意力的键位置。
| 位置 | 查询来源 | 键和值来源 | 需要屏蔽的键 |
|---|---|---|---|
| 编码器自注意力 | 源序列 | 源序列 | 源补零 |
| 解码器自注意力 | 目标前缀 | 目标前缀 | 未来位置与目标补零 |
| 解码器交叉注意力 | 当前目标表示 | 编码器输出 | 源补零 |
补零掩码屏蔽键,并不自动把补零查询的输出置零。训练时还需从损失中排除补零标签。任何有效查询若所有键均被屏蔽,都需显式处理,不能依赖对全负无穷得分求归一化。
PyTorch 不同注意力接口的布尔掩码约定可能不同。示例使用编码器层和解码器层接口,布尔值 True 表示禁止读取,不直接套用到其他接口。
2.3 逐位置前馈网络
Transformer前馈网络架构图
对任一位置的行向量
其中
当
ReLU 将负分量置零,正分量保持不变。若移除非线性,两次线性投影加偏置可以合并成一次仿射变换,扩张中间宽度本身就无法带来新的非线性表达能力。
一种平滑替代为
内容分支与门分支逐元素相乘,再投影回隐藏宽度。门值不必处于零到一之间,因此它是特征调制而非概率。普通双投影前馈层约有
经典结构使用 ReLU 前馈,代码也保持这一选择。上述变体用于解释结构差异,并非在同一层同时启用多种激活。
2.4 嵌入与输出概率
2.4.1 词元嵌入与输入缩放
设源词元 ID 为
Transformer输入编码架构图
输入编码的三次形状变化分别是整数索引到嵌入向量、同宽位置向量相加以及随机失活。位置不是额外拼接的一个通道,因此不会把隐藏宽度从
补零嵌入即使固定为零,加上位置编码后也不再为零。后续注意力必须依赖显式掩码,而不是通过“向量是否为零”判断有效位置。
2.4.2 词表投影与概率归一化
模型最后投影到大小为
对每个目标位置,沿词表维执行归一化:
该分布覆盖词表中的候选词元,不能沿时间轴归一化。训练以正确词元的负对数概率作为损失,推理则基于最后位置的分布选择下一词元。
Transformer输出预测架构图
词表投影在每个目标位置共享同一个矩阵。若
训练时直接向交叉熵传入 logits,框架以稳定形式结合对数归一化。推理时若使用贪心选择,直接取最大得分与取最大概率得到相同类别,不必先显式构建整份概率向量。
2.5 位置编码
嵌入宽度为
不同频率的正弦与余弦为每个位置提供不同的向量模式。相同词元出现在不同位置时,词元嵌入相同,但相加后的表示不同,使后续查询与键能够感知顺序。对固定位置偏移,正弦与余弦的加法公式还允许用线性关系表示对应频率分量的变化。
经典结构在词元嵌入与位置编码相加后使用随机失活。可学习绝对位置编码改为按位置查参数表,旋转位置编码则在查询与键上应用位置相关旋转,以改变点积中的相对位置关系。它们的注入位置和归纳偏置不同,不能把这些方法都当作同一个相加操作。固定正弦编码虽能计算训练长度以外的位置,也不保证模型一定能够可靠外推到更长序列。
3. 模型实现
3.1 嵌入与编码器—解码器
实现使用 PyTorch 基础层组装两个堆叠,保留后置归一化、ReLU 前馈和正弦位置编码。源与目标共享示例词表,但使用独立嵌入,不绑定输出投影权重;不额外增加堆叠末端归一化。
import copy
import math
import torch
from torch import nn
from torch.nn import functional as F
PAD, BOS, EOS = 0, 1, 2
class PositionalEmbedding(nn.Module):
def __init__(self, vocab_size, dim, max_length=64, dropout=0.1):
super().__init__()
if dim % 2:
raise ValueError("use an even hidden dimension")
self.embedding = nn.Embedding(vocab_size, dim, padding_idx=PAD)
self.dim = dim
position = torch.arange(max_length).float()[:, None]
frequency = torch.exp(torch.arange(0, dim, 2).float() * (-math.log(10000.) / dim))
encoding = torch.zeros(max_length, dim)
encoding[:, 0::2] = torch.sin(position * frequency)
encoding[:, 1::2] = torch.cos(position * frequency)
self.register_buffer("position", encoding)
self.dropout = nn.Dropout(dropout)
def forward(self, tokens):
if tokens.shape[1] > len(self.position):
raise ValueError("position capacity exceeded")
return self.dropout(self.embedding(tokens) * math.sqrt(self.dim) +
self.position[:tokens.shape[1]])
class Transformer(nn.Module):
def __init__(self, vocab_size=20, dim=32, heads=4, depth=2, dropout=0.1):
super().__init__()
self.source_embedding = PositionalEmbedding(vocab_size, dim, dropout=dropout)
self.target_embedding = PositionalEmbedding(vocab_size, dim, dropout=dropout)
self.encoder = nn.ModuleList([
nn.TransformerEncoderLayer(dim, heads, dim * 2, dropout,
activation="relu", batch_first=True,
norm_first=False) for _ in range(depth)
])
self.decoder = nn.ModuleList([
nn.TransformerDecoderLayer(dim, heads, dim * 2, dropout,
activation="relu", batch_first=True,
norm_first=False) for _ in range(depth)
])
self.output = nn.Linear(dim, vocab_size)
def encode(self, source):
source_mask = source.eq(PAD)
if source_mask.all(dim=1).any():
raise ValueError("source must contain at least one valid token")
memory = self.source_embedding(source)
for layer in self.encoder:
memory = layer(memory, src_key_padding_mask=source_mask)
return memory, source_mask
def decode(self, target, memory, source_mask):
if target.shape[1] == 0 or target[:, 0].eq(PAD).any():
raise ValueError("target must start with a valid token")
length = target.shape[1]
causal = torch.triu(torch.ones(length, length, device=target.device,
dtype=torch.bool), diagonal=1)
hidden = self.target_embedding(target)
for layer in self.decoder:
hidden = layer(hidden, memory, tgt_mask=causal,
tgt_key_padding_mask=target.eq(PAD),
memory_key_padding_mask=source_mask)
return self.output(hidden)
def forward(self, source, target):
memory, source_mask = self.encode(source)
return self.decode(target, memory, source_mask)
@torch.no_grad()
def generate(self, source, max_new_tokens=12):
self.eval()
memory, source_mask = self.encode(source)
target = torch.full((source.shape[0], 1), BOS, dtype=torch.long,
device=source.device)
finished = torch.zeros(source.shape[0], dtype=torch.bool, device=source.device)
for _ in range(max_new_tokens):
logits = self.decode(target, memory, source_mask)[:, -1].clone()
logits[:, [PAD, BOS]] = -torch.inf
next_token = logits.argmax(dim=-1)
next_token = torch.where(finished, torch.full_like(next_token, PAD), next_token)
target = torch.cat([target, next_token[:, None]], dim=1)
finished |= next_token.eq(EOS)
if finished.all():
break
return target
输入采用右侧补零,源序列和目标前缀至少包含一个有效词元。生成中已结束样本追加补零,不让它们影响其他样本;目标输出的补零查询仍不作为有效预测评价。
3.2 序列反转训练示例
合成任务将源词元序列反转,再预测终止标记。它用于验证训练与生成通路,不代表机器翻译效果。
torch.manual_seed(42)
source = torch.zeros(200, 8, dtype=torch.long)
target = torch.zeros(200, 9, dtype=torch.long)
for row in range(200):
length = int(torch.randint(3, 8, ()).item())
words = torch.randint(4, 20, (length,))
source[row, :length] = words
source[row, length] = EOS
target[row, 0] = BOS
target[row, 1:length + 1] = words.flip(0)
target[row, length + 1] = EOS
train_ids, valid_ids, test_ids = torch.arange(120), torch.arange(120, 160), torch.arange(160, 200)
model = Transformer()
optimizer = torch.optim.Adam(model.parameters(), lr=0.001)
best_loss, best_state = float("inf"), None
for epoch in range(50):
model.train()
order = train_ids[torch.randperm(len(train_ids))]
for ids in order.split(24):
optimizer.zero_grad(set_to_none=True)
logits = model(source[ids], target[ids, :-1])
loss = F.cross_entropy(logits.reshape(-1, 20), target[ids, 1:].reshape(-1),
ignore_index=PAD)
loss.backward()
optimizer.step()
model.eval()
with torch.no_grad():
logits = model(source[valid_ids], target[valid_ids, :-1])
valid_loss = F.cross_entropy(logits.reshape(-1, 20), target[valid_ids, 1:].reshape(-1),
ignore_index=PAD).item()
if valid_loss < best_loss:
best_loss = valid_loss
best_state = copy.deepcopy(model.state_dict())
model.load_state_dict(best_state)
model.eval()
with torch.no_grad():
logits = model(source[test_ids], target[test_ids, :-1])
test_loss = F.cross_entropy(logits.reshape(-1, 20), target[test_ids, 1:].reshape(-1),
ignore_index=PAD).item()
print("test_token_loss:", round(test_loss, 4))
print("generated_ids:", model.generate(source[test_ids[:2]]).tolist())
最佳轮次由验证损失选择。有限样本与较短训练预算下,生成结果仍可能重复、遗漏或错序,不要求示例完全学会反转。教师强制下的词元损失与自由生成质量不同,生成评价还需比较序列是否正确、是否按时终止,以及长度等因素,不能用一次前向准确率代替。
3.3 因果与补零不变性检查
model.eval()
with torch.no_grad():
sample_source = source[:2]
prefix = torch.tensor([[BOS, 4, 5, 6], [BOS, 7, 8, 9]])
changed = prefix.clone()
changed[:, 2:] = torch.tensor([[10, 11], [12, 13]])
original = model(sample_source, prefix)
modified = model(sample_source, changed)
assert torch.allclose(original[:, :2], modified[:, :2], atol=1e-5)
extended_source = F.pad(sample_source, (0, 2), value=PAD)
extended = model(extended_source, prefix)
assert torch.allclose(original, extended, atol=1e-5)
print("causal_and_padding_checks:", True)
改变未来目标输入不应影响更早位置输出,追加源端补零也不应改变有效上下文。这两项测试能发现常见掩码错误,但不能替代真实数据验证。
3.4 训练目标与序列对齐
对真实目标 [a,b,EOS],解码器输入为 [BOS,a,b],监督标签为 [a,b,EOS]。源端不必采用同样的右移规则。
交叉熵在有效目标位置上求均值:
教师强制提供完整的真实右移前缀,因果掩码保证每个位置只能读取合法历史,因此所有位置可以并行计算损失。训练输入若未右移,主对角线就可能直接泄漏当前答案。
3.5 自回归生成与结构变体
推理从 BOS 开始,预测一个词元,再把它追加到前缀。生成 EOS 后停止,或在达到最大长度时结束。贪心选择、束搜索与随机采样属于解码策略,不改变基础结构。
编码器表示可以只计算一次,解码器每步读取它。若进一步缓存历史键和值,可减少目标前缀的重复投影和计算;示例只复用编码器输出,不实现键值缓存。
仅编码器模型适合双向表示任务,仅解码器模型通常用因果自注意力生成序列,编码器—解码器模型通过交叉注意力执行条件生成。三种结构共享组件,但掩码与训练目标不同。
Transformer自回归生成架构图
第
3.6 计算成本与实现边界
隐藏维度为
标准显式注意力矩阵占用长度平方规模的空间,融合或分块算子可以减少中间存储与数据搬运,但不等于任意长序列的全部计算都变成线性。
示例省略权重绑定、标签平滑、专用预热调度、键值缓存与大规模数据处理,使用较窄前馈层验证结构。需要复现实验时,应匹配这些配置、分词与训练预算,而非只对齐层数和头数。
4. 总结
Transformer 将序列建模拆为多头注意力、逐位置非线性变换、残差和归一化。编码器读取完整源上下文,解码器通过因果自注意力读取目标前缀,再由交叉注意力接入源表示。
正确实现的关键在于输入右移、三类掩码和输出损失对齐。训练并行与生成顺序执行来自不同信息条件,明确这些条件,才能可靠扩展到表示学习、条件生成和其他序列任务。
5. 参考文献
[1] Vaswani A, Shazeer N, Parmar N, et al. Attention Is All You Need. NeurIPS, 2017, 30.
[2] Ba J L, Kiros J R, Hinton G E. Layer Normalization. arXiv:1607.06450, 2016.
[3] Sutskever I, Vinyals O, Le Q V. Sequence to Sequence Learning with Neural Networks. NeurIPS, 2014, 27.