位置编码
总阅读量 加载中... 次
位置编码(Positional Encoding)是 Transformer 架构中的关键组件之一。由于 Transformer 采用自注意力机制进行信息交互,其本身不具备处理序列顺序的能力——无论输入序列如何打乱,注意力计算的输出结果都是相同的。位置编码的引入正是为了解决这一问题,使模型能够区分序列中不同位置的 token。
本文围绕 Transformer 中的位置编码技术展开综述,介绍绝对位置编码与相对位置编码两类主流方法。
1. 背景与问题定义
在 Transformer 的自注意力计算中:
公式本身对输入序列的顺序是对称的——交换输入序列中两个 token 的位置,注意力矩阵的值不会发生任何变化。这意味着,如果不额外引入位置信息,模型将无法区分"我爱你"和"你爱我"这类语序敏感的任务。
位置编码的核心目标是为序列中的每个位置
绝对位置编码是最早被提出的位置编码方案,为序列中的每个绝对位置生成一个固定的编码向量。
2. 可学习位置编码
Learnable 位置编码(可学习位置编码)最早由 Bahdanau 等人在论文《Neural Machine Translation by Jointly Learning to Align and Translate》(2014)中提出,随后被广泛应用于早期神经机器翻译模型。
其核心思想是将位置编码视为可学习的参数矩阵
2.1 代码实现
class LearnablePositionalEncoding(torch.nn.Module):
"""
Learnable Positional Encoding
论文来源:Bahdanau et al., 2014
"""
def __init__(self, d_model: int, max_len: int = 5000):
super(LearnablePositionalEncoding, self).__init__()
self.position_embeddings = torch.nn.Embedding(max_len, d_model)
def forward(self, x: torch.Tensor) -> torch.Tensor:
"""
:param x: Tensor, shape = [batch_size, seq_len, d_model]
:return: Tensor, shape = [batch_size, seq_len, d_model]
"""
batch_size, seq_len, _ = x.shape
# 生成位置索引 [0, 1, 2, ..., seq_len-1]
positions = torch.arange(seq_len, device=x.device).expand(batch_size, seq_len)
return x + self.position_embeddings(positions)
3. 正弦位置编码
Sinusoidal 位置编码(正弦位置编码)是 Transformer 架构奠基之作 Attention Is All You Need 中提出的一种绝对位置编码技术。它不需要通过数据训练去学习,而是直接利用不同频率的正弦和余弦函数组合,为序列中的每个位置生成一个固定的、唯一的特征向量。
3.1 核心数学公式
假设我们需要为一个长度为
对于序列中的第
公式拆解:
-
-
-
3.2 完整的计算步骤(矩阵视角)
在工程实现中,通常不会用双重循环去逐个元素计算,而是采用矩阵化操作。以下是完整的全矩阵计算流程:
第一步:构建位置向量 (Position Vector)
创建一个形状为
第二步:计算逆频率向量 (Inverse Frequency Vector)
根据维度的前半部分(偶数项),计算缩放系数(也叫角速度
其形状为
第三步:计算角度矩阵 (Angles Matrix)
将位置列向量与逆频率行向量进行外积(Matrix Outer Product)相乘,得到一个形状为
第四步:应用
- 对角度矩阵的每一个元素求正弦,得到
- 对角度矩阵的每一个元素求余弦,得到
最后,将这两个矩阵横向拼接。在标准实现中,通常是以交错(Interleave)或者前后拼接的方式组合。
如果采用交错拼接,最终得到的位置编码矩阵
3.3 直观理解:它长什么样?
如果我们将最终的
- 纵轴(位置
- 横轴(维度
- 左侧(低维区域):
- 右侧(高维区域):频率极低,图形随着
这种设计使得每一个位置的
3.4 为什么要这样设计?(设计巧妙之处)
原论文指出,选择正弦和余弦函数的核心原因在于:它允许模型轻松学习到相对位置关系。
根据三角函数的和差化积公式:
这意味着,对于任何固定的相对偏移量
也就是说,Attention 机制在计算两个相距为
最后,生成好这个
3.5 代码实现
import torch
import math
class SinusoidalPositionalEncoding(torch.nn.Module):
"""
Sinusoidal Positional Encoding
论文来源:Vaswani et al., 2017
"""
def __init__(self, d_model: int, max_len: int = 5000):
super(SinusoidalPositionalEncoding, self).__init__()
# 创建位置编码矩阵 [max_len, d_model]
pe = torch.zeros(max_len, d_model)
position = torch.arange(0, max_len, dtype=torch.float).unsqueeze(1) # [max_len, 1]
# 计算除数 10000^(2i/d_model)
div_term = torch.exp(
torch.arange(0, d_model, 2, dtype=torch.float) * (-math.log(10000.0) / d_model)
) # [d_model/2]
pe[:, 0::2] = torch.sin(position * div_term) # 偶数维度
pe[:, 1::2] = torch.cos(position * div_term) # 奇数维度
pe = pe.unsqueeze(0) # [1, max_len, d_model] 便于批量相加
self.register_buffer('pe', pe) # 注册为 buffer,不参与梯度更新
def forward(self, x: torch.Tensor) -> torch.Tensor:
"""
:param x: Tensor, shape = [batch_size, seq_len, d_model]
:return: Tensor, shape = [batch_size, seq_len, d_model]
"""
return x + self.pe[:, :x.size(1), :]
3.6 绝对位置编码对比
| 特性 | Learnable | Sinusoidal |
|---|---|---|
| 论文来源 | Bahdanau et al., 2014 | Vaswani et al., 2017 |
| 参数量 |
|
无需额外参数 |
| 外推能力 | 有限(受 max_len 限制) | 理论支持(周期函数) |
| 灵活性 | 可学习、更灵活 | 固定、不可调优 |
| 效果 | 通常略优于 Sinusoidal | 表现稳定 |
绝对位置编码在处理长序列时存在明显的局限性:一方面,模型难以直接学习位置之间的相对关系;另一方面,当测试序列长度超过训练集最大长度时,编码效果急剧下降。相对位置编码通过直接编码 token 之间的相对距离来解决这些问题。
4. RoPE 位置编码
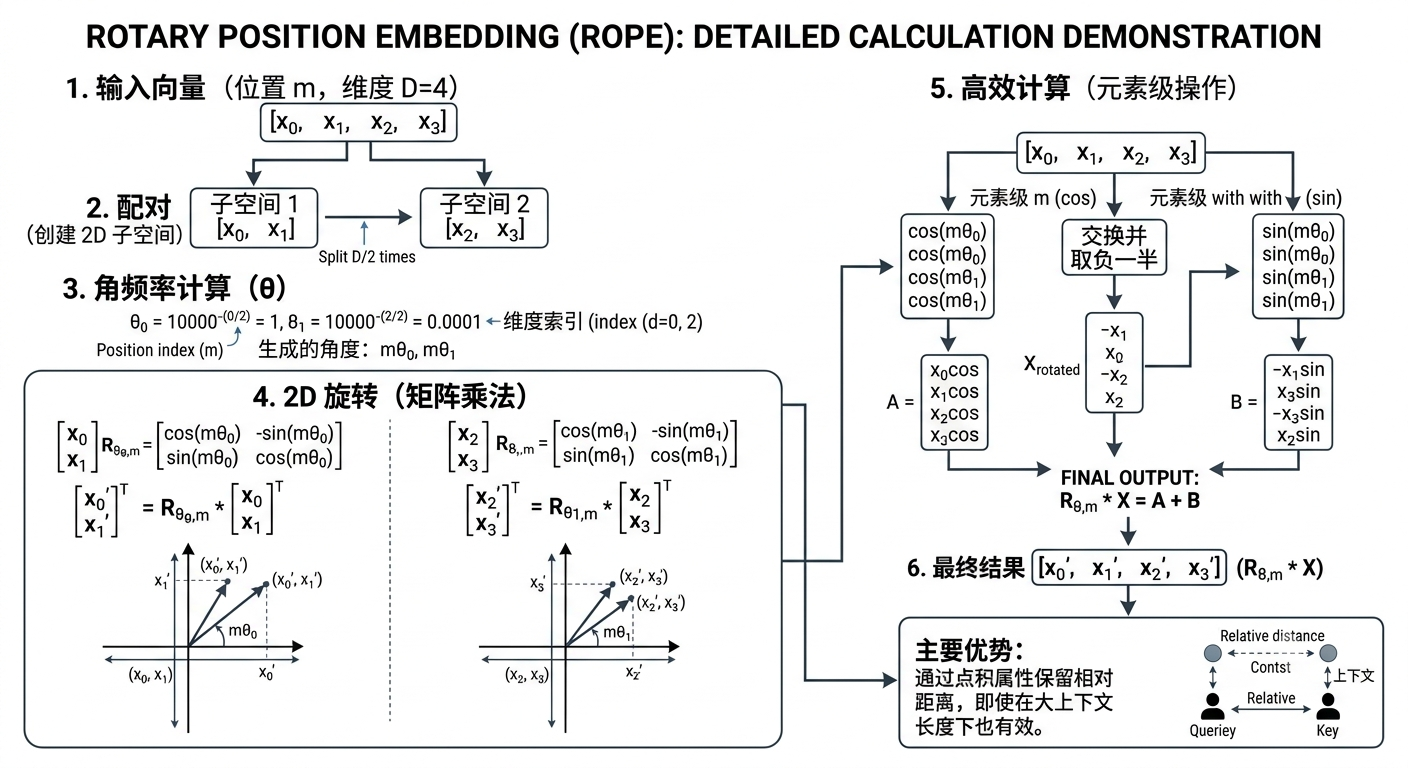
旋转位置编码(Rotary Position Embedding,RoPE)由 Su 等人在论文《RoFormer: Enhanced Transformer with Rotary Position Embedding》(2022)中提出,是目前大语言模型(如 LLaMA、Baichuan、Mistral 等)中最主流的位置编码技术之一。它的核心思想是:通过在复数空间中旋转 Query 和 Key 向量,将绝对位置信息自然地转化为相对位置信息。
4.1 核心数学思想
RoPE 的核心目标是:通过一个变换函数
具体来说,假设输入两个特征向量
RoPE 巧妙地利用了二维空间中的旋转矩阵来实现这一特性。在二维空间中,旋转一个向量不改变其长度,只改变其角度。
在 RoPE 中,这个变换函数的具体形式为:
其中
4.2 完整的计算步骤
在实际的 Transformer 架构中,假设多头注意力机制中某个头的维度为
第一步:拆分二维子空间
因为旋转是在二维平面上定义的,RoPE 会将一个
对于位置为
第二步:计算每个子空间的旋转角度
RoPE 为不同的二维子空间分配不同的旋转基数(类似于 Transformer 原始正弦位置编码)。
对于第
在位置
第三步:应用旋转变换(矩阵相乘)
对于第
展开后的计算结果为:
将所有子空间旋转后的结果重新拼接,就得到了带有位置
4.3 整体矩阵表示
如果将上述过程写成一个整体的大矩阵乘以
4.4 高效的工程实现
在代码实现中,直接进行大型稀疏矩阵乘法效率极低。为了加速,通常会利用逐元素相乘(Element-wise Product)的 trick。
我们将原向量
同时,我们将所有的
最终的 RoPE 计算可以精简为两组向量的哈达玛积(Hadamard Product,即对应位置直接相乘)之和:
提示: 在很多主流模型(如 LLaMA)的代码实现中,为了内存对齐和计算方便,二维切分的方式不是
邻近切分,而是前后对半切分(前 维与后 维两两配对)。虽然切分方式不同,但数学本质完全一致。
4.5 为什么能表示相对位置?
当计算位置
由于旋转矩阵是正交矩阵,满足
因此:
结论: 经过 RoPE 编码后,Query 和 Key 的点积结果只取决于它们的相对距离
4.6 代码实现
import torch
import math
class RoPEPositionalEncoding(torch.nn.Module):
"""
Rotary Position Embedding
论文来源:Su et al., 2022
"""
def __init__(self, dim: int, base: int = 10000):
super(RoPEPositionalEncoding, self).__init__()
self.dim = dim
self.base = base
# 预计算旋转角度 inv_freq[i] = theta_i
inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float() / dim))
self.register_buffer('inv_freq', inv_freq)
def forward(self, seq_len: int, device: torch.device = None):
"""
生成旋转角度矩阵
:param seq_len: 序列长度
:param device: 计算设备
:return: 旋转角度矩阵 [seq_len, dim/2]
"""
if device is None:
device = self.inv_freq.device
t = torch.arange(seq_len, device=device, dtype=self.inv_freq.dtype)
# 外积得到 [seq_len, dim/2]
freqs = torch.einsum('i,j->ij', t, self.inv_freq)
emb = torch.cat([freqs, freqs], dim=-1) # [seq_len, dim]
return emb
@staticmethod
def apply_rotary_emb(x: torch.Tensor, cos: torch.Tensor, sin: torch.Tensor):
"""
应用旋转编码到输入向量
:param x: 输入向量 [batch, num_heads, seq_len, dim]
:param cos: 余弦值 [seq_len, dim]
:param sin: 正弦值 [seq_len, dim]
:return: 旋转后的向量
"""
# 将 cos/sin 扩展为与 x 相同的维度
cos = cos.unsqueeze(0).unsqueeze(0) # [1, 1, seq_len, dim]
sin = sin.unsqueeze(0).unsqueeze(0)
# 旋转公式:x_rot = x * cos + rotate(x) * sin
# 其中 rotate(x) = [-x[..., 1::2], x[..., ::2]]
x1 = x[..., :x.size(-1)//2]
x2 = x[..., x.size(-1)//2:]
return torch.cat([
x1 * cos[..., :x1.size(-1)] - x2 * sin[..., :x2.size(-1)],
x1 * sin[..., :x1.size(-1)] + x2 * cos[..., :x2.size(-1)]
], dim=-1)
5. YaRN 位置编码
YaRN(Yet another RoPE extensioN method)是目前大语言模型(LLM)用于**长文本上下文扩展(Context Window Extension)**最先进、效果最好的技术之一。
它的核心痛点在于:标准的 RoPE 无法直接推广到比预训练更长的序列(会外推失败)。YaRN 基于"NTK-by-parts"插值法,通过对不同特征维度(频率)进行分段非线性缩放,并引入温度修正,使得模型只需极少的数据微调,就能将上下文窗口扩展 16 倍以上(例如从 4k 扩展到 64k/128k)。
5.1 核心理论:频率分段
RoPE 的本质是不同维度有着不同的旋转"波长"。YaRN 的核心观察是:不同波长的维度,在扩展上下文时扮演的角色完全不同。
若预训练的最大长度为
-
高频维度(波长
-
低频维度(波长
-
中频维度:处于两者之间,YaRN 采用平滑过渡(Smooth Blend)。
5.2 完整的计算步骤
假设我们要将上下文从原长度
第一步:计算原始的波长
对于特征维度为
第二步:定义分段边界(超参数
YaRN 引入了两个超参数
- 当
- 当
为了方便计算,通常将其转化为维度索引边界(即根据上面的波长公式反推出具体的维度
- 高频边界对应的维度索引
- 低频边界对应的维度索引
第三步:计算渐变比例函数
对于当前的维度索引
第四步:计算 YaRN 的新频率(角速度)
利用
- 解读: 当
第五步:注意力温度修正(Attention Temperature Scaling)
这是 YaRN 相比之前方法的另一大关键创新。当位置编码被压缩后,不同位置向量之间的平均点积值会变小(因为角度靠得更近了)。这会导致 Attention 矩阵的熵增加,分布变得极其平缓,从而丧失了注意力集中的能力。
为了抵消这一副作用,YaRN 引入了一个注意力温度放大系数
在计算应用完位置编码的 Query (
5.3 最终矩阵应用
最终,对于任何一个绝对位置为
5.4 总结与意义
YaRN 位置编码计算流程的伟大之处在于:
- 局部高精度:保证了相邻 Token 之间的短距离高频相对位置信息完全不失真。
- 全局自适应:长距离的信息通过动态插值被优雅地压缩在新窗口内。
- 无痛扩展:通过温度因子
这也使得 LLaMA-2/3、Mistral 等主流开源模型在需要扩展长文本时,普遍首选基于 YaRN 变体的解决方案。
5.5 代码实现
import torch
import math
class YaRNPositionalEncoding(torch.nn.Module):
"""
Yet another RoPE extensioN
论文来源:Peng et al., 2023
"""
def __init__(self, dim: int, base: int = 10000, original_max_position_embeddings: int = 2048,
scaling_factor: float = 1.0):
super(YaRNPositionalEncoding, self).__init__()
self.dim = dim
self.base = base
self.scaling_factor = scaling_factor
# 原始训练的最大长度
self.original_max_position_embeddings = original_max_position_embeddings
# 重新计算缩放后的 base
self.base = base * (scaling_factor ** (dim / (dim - 2)))
# 预计算旋转角度
inv_freq = 1.0 / (self.base ** (torch.arange(0, dim, 2).float() / dim))
self.register_buffer('inv_freq', inv_freq)
def forward(self, seq_len: int, device: torch.device = None):
"""生成旋转角度矩阵(支持缩放)"""
if device is None:
device = self.inv_freq.device
# 对位置索引进行缩放
t = torch.arange(seq_len, device=device, dtype=self.inv_freq.dtype)
t = t / self.scaling_factor # 线性缩放
freqs = torch.einsum('i,j->ij', t, self.inv_freq)
emb = torch.cat([freqs, freqs], dim=-1)
return emb
@staticmethod
def apply_rotary_emb(x: torch.Tensor, cos: torch.Tensor, sin: torch.Tensor):
"""应用旋转编码(与 RoPE 相同)"""
cos = cos.unsqueeze(0).unsqueeze(0)
sin = sin.unsqueeze(0).unsqueeze(0)
x1 = x[..., :x.size(-1)//2]
x2 = x[..., x.size(-1)//2:]
return torch.cat([
x1 * cos[..., :x1.size(-1)] - x2 * sin[..., :x2.size(-1)],
x1 * sin[..., :x1.size(-1)] + x2 * cos[..., :x2.size(-1)]
], dim=-1)
6. 总结
本文综述了位置编码技术的发展历程,从最早的可学习位置编码(Bahdanau et al., 2014),到 Transformer 的标准方案 Sinusoidal(Vaswani et al., 2017),再到近年来针对长序列优化的相对位置编码(RoPE、YaRN),研究者们始终在解决一个核心问题:如何让模型有效感知序列中的位置信息。
| 方法 | 论文来源 | 类型 | 外推能力 |
|---|---|---|---|
| Learnable | Bahdanau et al., 2014 | 绝对 | 有限 |
| Sinusoidal | Vaswani et al., 2017 | 绝对 | 理论支持 |
| RoPE | Su et al., 2022 | 相对 | 强 |
| YaRN | Peng et al., 2023 | 相对 | 最强 |
当前主流大语言模型普遍采用 RoPE 或 YaRN 作为位置编码方案。YaRN 通过 NTK 感知缩放技术,在长文本处理方面展现出显著优势,已成为大模型长上下文扩展的推荐方案。