BERT:双向编码器与预训练机制
总阅读量 加载中... 次
BERT 的全称是双向 Transformer 编码器表示,先通过大规模文本预训练获得上下文表示,再针对分类、词元标注或抽取式问答等任务微调。相关工作于 2018 年公开,并发表于 NAACL 2019 [1]。
模型以双向编码器为主干,使用掩码语言模型和下一句预测联合预训练。它不通过因果解码器逐词生成答案,而是让输入中每个有效位置读取左右上下文,形成与整段输入相关的表示。
1. 背景
单向语言模型只能依据左侧或右侧预测,而自然语言理解往往需要两侧线索。例如,“苹果发布新产品”和“苹果已经成熟”中的同一词语,需要上下文才能确定含义。
如果把完整答案放入双向网络,再要求预测每个位置的原词元,模型就可能直接读取自身。BERT 随机选择部分位置改变输入,再要求恢复原词元,使双向上下文学习具有明确的监督目标。
预训练不需要人工逐条标注类别,但仍然存在由文本构造的监督标签。下游微调则保留主干结构,增加任务输出层,并联合更新相应参数。
2. 模型架构
2.1 整体结构
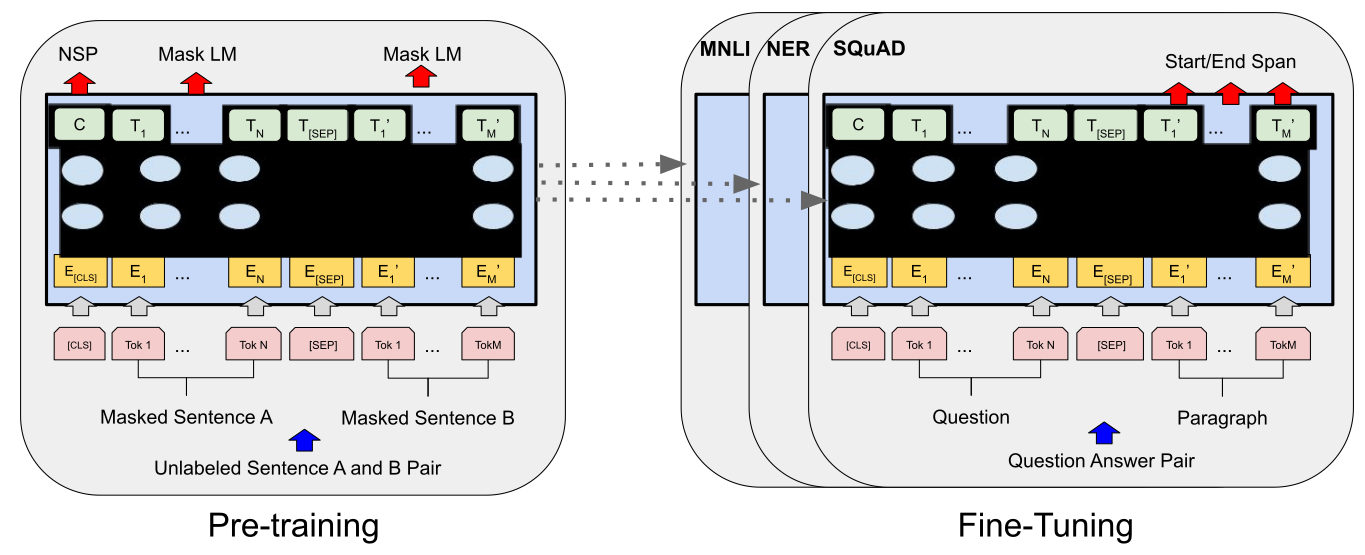
BERT架构图
预训练和微调共享多层编码器,区别主要在输入组织和输出监督。BERT-Base 使用 12 层、隐藏宽度 768、12 个注意力头,参数量约 1.1 亿;BERT-Large 使用 24 层、宽度 1024、16 个头,参数量约 3.4 亿。
基础结构没有编码器—解码器交叉注意力,也没有目标侧因果掩码。每层保持
2.2 词元、句段与位置表示
BERT输入表示架构图
句对输入组织为:
[CLS] 句段A [SEP] 句段B [SEP] [PAD] ...
单句输入保留 [CLS] 与一个结尾 [SEP],无需虚构第二句。WordPiece 把文本分解为子词,词元不必与完整自然语言单词一一对应。
设词元 ID 为
三组向量宽度相同,逐元素相加而非拼接。经典 BERT 使用可学习绝对位置表,不是固定正弦位置编码,也不在该相加式中要求词元嵌入乘以隐藏宽度平方根。
A 段及其 [CLS]、[SEP] 使用句段 ID 0,B 段及其结尾 [SEP] 使用 ID 1。句段 ID 区分两个输入片段,不是每句递增的自然语言句子编号;双向注意力仍可跨越两段。
2.3 双向多头自注意力
BERT编码器架构图
对当前层表示
查询表达当前位置检索需求,键用于匹配上下文位置,值承载被聚合的信息。头内计算为:
[MASK] 的位置依然是有效词元,需要参与表示计算;词元被替换与注意力边被屏蔽是两件不同的事。
若有
2.4 前馈、残差与归一化
编码器块采用后置归一化:
逐位置前馈网络为:
中间宽度通常为
层归一化沿每个词元的隐藏维度计算均值与方差,再执行可学习仿射变换。残差相加要求前后同宽,不增加序列长度。各层配置相同但参数独立,经典 BERT 并不共享全部编码器层权重。
2.5 掩码语言模型
从普通输入词元中选择约
-
[MASK]; -
-
这些比例以选中位置为分母,并不是将全部词元的
保持少量词元不变或随机替换,可以缓和预训练中频繁出现 [MASK] 而微调时没有它的差异,但不保证完全消除这种差异。特殊标记与补零位置不参与普通预测位置采样。
目标为:
2.6 预训练输出头
BERT预训练输出架构图
MLM 对词元表示执行线性变换、GELU 和层归一化,再投影到词表:
输出词表投影可与输入词元表共享权重,词表维偏置单独学习。训练只对选中位置计入损失,即使实现为所有位置生成词表得分,也不能把其余位置一起监督为复制输入。
下一句预测使用 [CLS] 位置表示,先做池化变换:
这里的“池化”是对 [CLS] 的可学习变换,不是对所有词元取均值。两种头并行读取同一主干输出,联合目标为
2.7 下一句预测与样本构造
预训练样本中,约一半 B 段来自 A 段之后的连续文本,另一半从语料中随机抽取。目标是判断是否为构造定义的后续片段,而不是判断两段语义是否相似,也不是预测下一句的具体文字。
“句段”可以包含多句自然语言文本。随机负例有时也可能主题相近,因此该任务依赖具体采样协议。后续模型可以改变或移除这一目标,但经典 BERT 的预训练包含它。
2.8 微调任务结构
| 任务 | 使用的表示 | 输出与监督 |
|---|---|---|
| 单句或句对分类 | [CLS] 或其池化表示 |
类别得分与分类损失 |
| 词元标注 | 各有效词元表示 | 逐词元类别;处理子词标签对齐 |
| 抽取式问答 | 问题与段落联合表示 | 各位置的起点、终点得分 |
| 回归 | 序列级表示 | 连续目标与回归损失 |
微调时通常替换预训练输出头,并联合更新主干。抽取式问答还需要排除不合法的答案区域、限制起终点组合,不能只独立取两个最大索引而忽略跨度约束。
[CLS] 表示并非无需训练就具有可靠语义相似度的通用句向量。检索或相似度任务需要匹配的训练目标、池化方式和评价协议。
3. 模型实现
3.1 输入扰动
PyTorch 示例使用已转为 ID 的短句对,0,1,2,3 分别表示补零、分类标记、分隔标记与掩码标记,其余为普通词元。不包含 WordPiece 分词训练,也不加载预训练权重。
import torch
from torch import nn
from torch.nn import functional as F
PAD, CLS, SEP, MASK = 0, 1, 2, 3
IGNORE = -100
def corrupt_tokens(tokens, vocab_size, probability=0.15):
if not 0 < probability <= 1 or vocab_size <= 4:
raise ValueError("invalid masking configuration")
eligible = tokens.ge(4)
selected = (torch.rand(tokens.shape, device=tokens.device) < probability) & eligible
# 小型演示批次保证有一个监督位置,避免空目标均值。
if eligible.any() and not selected.any():
selected.flatten()[eligible.flatten().nonzero()[0, 0]] = True
labels = tokens.clone().masked_fill(~selected, IGNORE)
corrupted = tokens.clone()
choice = torch.rand(tokens.shape, device=tokens.device)
corrupted[selected & (choice < 0.8)] = MASK
replace = selected & (choice >= 0.8) & (choice < 0.9)
random_words = torch.randint(4, vocab_size, tokens.shape, device=tokens.device)
corrupted[replace] = random_words[replace]
return corrupted, labels
随机替换只从普通词元采样,是示例的明确限制。强制至少一个监督位置也会略微改变极短批次的采样比例;大规模构造可以按固定目标数量采样,或跳过没有有效目标的批次。
3.2 编码器与两类预训练头
class BertPretraining(nn.Module):
def __init__(self, vocab_size=32, dim=32, heads=4, depth=2,
max_length=32, dropout=0.1):
super().__init__()
self.word = nn.Embedding(vocab_size, dim, padding_idx=PAD)
self.segment = nn.Embedding(2, dim)
self.position = nn.Embedding(max_length, dim)
self.input_norm = nn.LayerNorm(dim, eps=1e-12)
self.dropout = nn.Dropout(dropout)
self.encoder = nn.ModuleList([
nn.TransformerEncoderLayer(
dim, heads, 4 * dim, dropout=dropout,
activation="gelu", layer_norm_eps=1e-12,
batch_first=True, norm_first=False,
) for _ in range(depth)
])
self.mlm_dense = nn.Linear(dim, dim)
self.mlm_norm = nn.LayerNorm(dim, eps=1e-12)
self.vocab_bias = nn.Parameter(torch.zeros(vocab_size))
self.pooler = nn.Linear(dim, dim)
self.nsp = nn.Linear(dim, 2)
def forward(self, tokens, segments):
batch, length = tokens.shape
if segments.shape != tokens.shape or length > self.position.num_embeddings:
raise ValueError("invalid sequence shape")
if tokens[:, 0].ne(CLS).any():
raise ValueError("each sequence must start with CLS")
padding_mask = tokens.eq(PAD)
positions = torch.arange(length, device=tokens.device)[None, :]
hidden = self.word(tokens) + self.segment(segments) + self.position(positions)
hidden = self.dropout(self.input_norm(hidden))
for layer in self.encoder:
hidden = layer(hidden, src_key_padding_mask=padding_mask)
transformed = self.mlm_norm(F.gelu(self.mlm_dense(hidden)))
mlm_logits = F.linear(transformed, self.word.weight, self.vocab_bias)
pooled = torch.tanh(self.pooler(hidden[:, 0]))
return mlm_logits, self.nsp(pooled), hidden
def pretraining_loss(mlm_logits, mlm_labels, nsp_logits, nsp_labels):
if mlm_labels.ne(IGNORE).any():
mlm_loss = F.cross_entropy(mlm_logits.reshape(-1, mlm_logits.shape[-1]),
mlm_labels.reshape(-1), ignore_index=IGNORE)
else:
mlm_loss = mlm_logits.sum() * 0.0
nsp_loss = F.cross_entropy(nsp_logits, nsp_labels)
return mlm_loss + nsp_loss
双向编码器没有传入上三角因果矩阵,只屏蔽补零键。词元嵌入和输出投影共享同一个参数,因此补零行即使在查表路径不获得梯度,也可能从输出分类路径获得梯度;padding_idx 不会冻结共享参数的所有使用路径。
词表得分为
3.3 训练与机制检查
torch.manual_seed(42)
tokens = torch.tensor([
[CLS, 4, 5, SEP, 6, 7, SEP, PAD],
[CLS, 8, 9, SEP, 10, 11, SEP, PAD],
])
segments = torch.tensor([[0, 0, 0, 0, 1, 1, 1, 0]]).repeat(2, 1)
nsp_labels = torch.tensor([0, 1])
model = BertPretraining()
optimizer = torch.optim.AdamW(model.parameters(), lr=0.001, weight_decay=0.01)
for step in range(20):
model.train()
corrupted, mlm_labels = corrupt_tokens(tokens, vocab_size=32)
optimizer.zero_grad(set_to_none=True)
mlm_logits, nsp_logits, _ = model(corrupted, segments)
loss = pretraining_loss(mlm_logits, mlm_labels, nsp_logits, nsp_labels)
loss.backward()
optimizer.step()
model.eval()
with torch.no_grad():
mlm_logits, nsp_logits, hidden = model(tokens, segments)
extended = F.pad(tokens, (0, 2), value=PAD)
extended_segments = F.pad(segments, (0, 2), value=0)
extended_hidden = model(extended, extended_segments)[2]
assert torch.allclose(hidden[:, :7], extended_hidden[:, :7], atol=1e-5)
print("hidden_shape:", tuple(hidden.shape))
print("mlm_nsp_shapes:", tuple(mlm_logits.shape), tuple(nsp_logits.shape))
print("padding_check:", True)
手写 ID 与标签仅用于运行形状、损失和梯度,不代表从真实语料按连续关系构造的有效预训练集。20 次更新不能获得可用的语言理解能力,也不能据此报告下游效果。
补零查询位置本身可能输出非零值,检查仅比较有效词元。若把全部补零行加入平均池化或损失,仍会引入错误监督。
3.4 训练设置与实现边界
经典预训练使用 BooksCorpus 与英文维基文本,序列长度预算包含特殊标记,模型的位置表上限为 512。训练大部分更新使用较短序列,末段增加长序列比例,以平衡成本和长位置学习 [1]。
示例使用较小主干、普通随机初始化和动态随机扰动,没有复现固定预训练样本构造、完整词表、初始化约定与大规模学习率计划。要复现实验或加载检查点,还需要匹配 GELU 近似、归一化稳定项、特殊 ID 及分词大小写设置。
单层注意力主要成本为
4. 总结
BERT 通过三类嵌入和双向编码器构建上下文表示,以选中词元恢复和片段关系判断联合预训练,再通过任务头将同一主干迁移到不同语言理解任务。
正确实现需要区分输入扰动、注意力补零掩码与损失忽略位置,并明确特殊标记、句段 ID 和子词标签的语义。预训练配置、数据构造和独立评价共同决定表示能否有效迁移。
5. 参考文献
[1] Devlin J, Chang M W, Lee K, Toutanova K. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. NAACL-HLT, 2019: 4171–4186.
[2] Vaswani A, Shazeer N, Parmar N, et al. Attention Is All You Need. NeurIPS, 2017, 30.
[3] Hendrycks D, Gimpel K. Gaussian Error Linear Units. arXiv:1606.08415, 2016.